RMM:把 Transformer 矩阵乘法切到刚好够用
一个 Transformer 每生成一个 token,都会重复做大量矩阵乘法。
我们平时讨论推理优化,很容易把注意力放在更显眼的东西上:KV cache 太大,所以压缩历史 token;模型太大,所以量化权重;上下文太长,所以裁掉不重要的片段。这些方向都对,但它们绕开了一个更细的问题:当模型真的在算 A × B 时,那个被逐项相乘再相加的共享维度,是否每一项都必须参与?
这篇论文问的就是这个问题。
不是把模型剪小,不是重新训练一个稀疏模型,也不是把 prompt 变短。研究者提出 Reduced Matrix Multiplication,简称 RMM:每次做矩阵乘时,先看当前输入激活在哪些维度上更“有力”,只保留这些维度去完成乘法。保留多少,由一个 retention ratio 控制。RR=0.8 就保留 80%,RR=0.5 就保留一半。
听起来像一个很直接的近似。
真正有意思的地方在于:它不是只问“能不能省算力”,而是把 Transformer 内部不同矩阵乘的可约性边界测了一遍。结果不是“所有地方都有冗余”,而是更细:注意力侧的计算明显更能忍受减少;MLP 侧,尤其某些投影,一旦切得太狠就会失稳。这个边界,可能比单个加速方法本身更值得记住。
先把“矩阵乘可以少算”这件事想清楚
矩阵乘法看起来是一个固定动作:左边矩阵的一行,和右边矩阵的一列,对齐、相乘、求和,得到输出里的一个数。
但这个“对齐”的方向很关键。
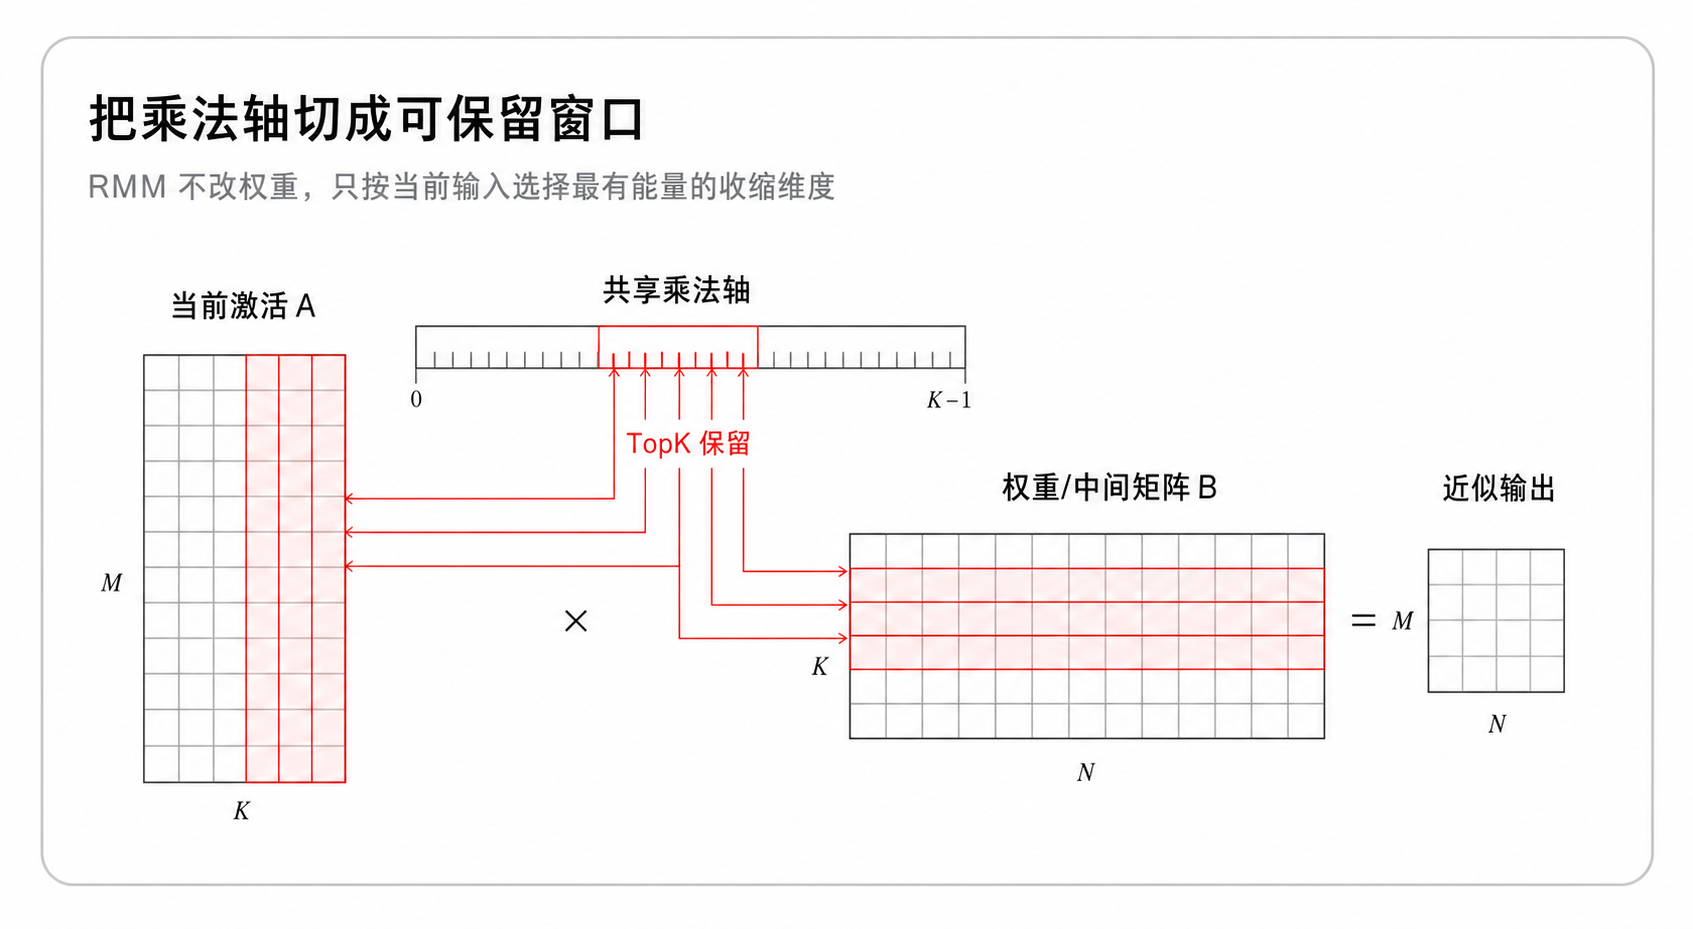
假设我们把一次矩阵乘写成 Y = A B。A 的形状是 n × d,B 的形状是 d × m。中间那个 d,就是两边共享的收缩维度。输出的每个元素,本质上都是沿着这条 d 维轴做一次加权求和。
现在我们问一个朴素问题:如果 A 的某些列在当前输入下几乎没有能量,那它们参与这次求和的贡献是不是也更可疑?
RMM 的做法很简单。对每个维度 j,计算当前激活列 A[:, j] 的 L2 范数,把它当成这个维度的重要性分数。然后按 retention ratio 取 TopK,只算这些维度:
RMMρ(A, B) = A[:, I] B[I, :]
这里的 I 是被选中的维度集合,大小是 ceil(ρd)。
注意这一步没有改权重。B 还是原来的权重或中间表示,只是这次乘法只让其中一部分行参与。下一次输入来了,A 变了,TopK 也可能变。于是这个方法既不是固定剪枝,也不是训练后的稀疏结构,而是一种每次前向传播都重新选择的输入自适应近似。
论文还给了一个理论支撑:如果我们只知道当前的 A,又要在任意可能的 B 上控制最坏情况误差,那么按 A 的列范数做 TopK 是 minimax optimal。这个证明不意味着下游任务一定不掉点,但它说明这个选择规则不是随手拍脑袋:在“只看当前激活、预算固定”的设定下,它是一个合理的保守策略。
为什么不能用一个固定子空间
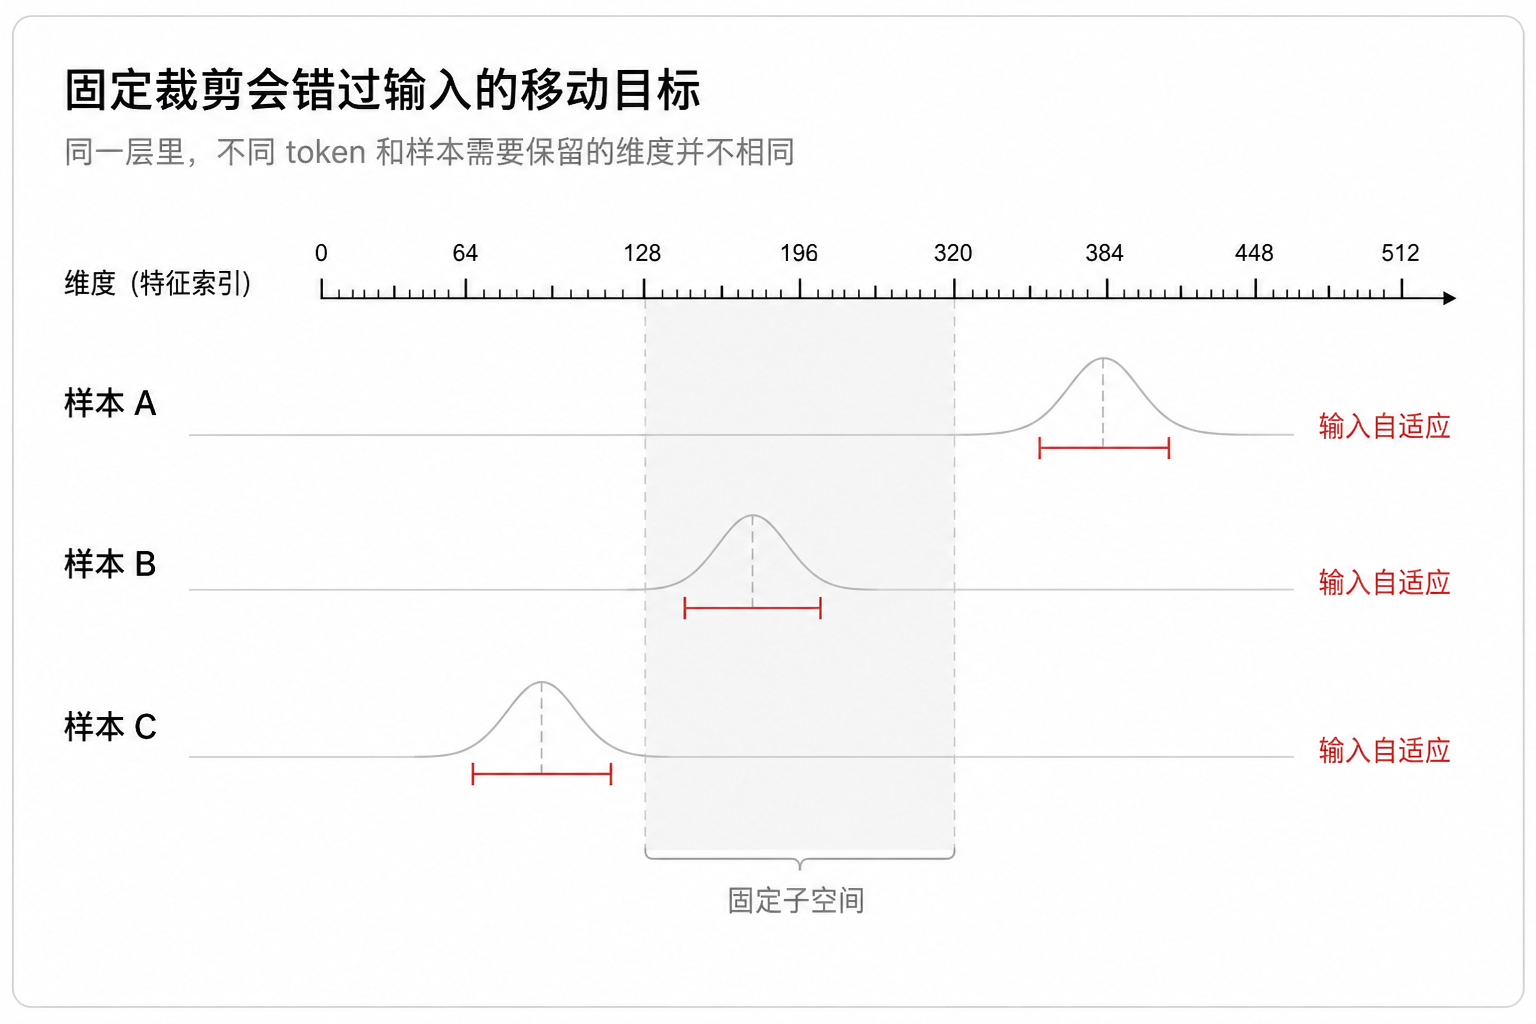
直觉上,我们可能会想:既然有些维度不重要,能不能先统计一遍,找出长期不重要的维度,然后以后都不算?
这正是静态剪枝和固定子空间方法容易遇到的问题。
Transformer 的激活不是一张静态地图。不同 prompt、不同 token、不同层、不同 attention head,可能会把信息压到不同维度上。一个维度在这个样本里安静,不代表它在另一个样本里也安静;一个维度在 prefill 里不显眼,也不代表 decode 到某一步时不重要。
所以,固定裁掉一组维度,本质上是在赌“模型的信息分配长期不变”。这个赌注在一些任务和较高保留率下可能勉强成立,但一旦保留率降到 0.5,错误就会明显累积。
论文在 LLaMA 3.1 8B 上做了一个很清楚的对照。固定 RR=0.5,在 ARC-C、ARC-E、COPA、PIQA、CommonsenseQA 五个零样本 QA 任务上,完整模型平均准确率是 69.8。RMM 平均 59.8。这个下降不小,但在所有剪枝方法里最好。SparseGPT 是 56.1,Wanda 是 52.7,SliceGPT 和 magnitude pruning 分别只有 37.0 和 39.3。
这里的重点不是 RMM 完全无损。它不是。重点是,在同样只保留一半预算的情况下,输入自适应选择比固定结构更不容易把关键维度一起切掉。
生成任务上的差异更直观。CNN/DailyMail 摘要中,LLaMA 3.1 8B 的完整模型 ROUGE-1 是 37.4。RMM 在 RR=0.8 时是 37.5,几乎贴住完整模型;在 RR=0.5 时降到 34.2。静态方法在 RR=0.5 下只有 28.0,随机动态选择更是掉到 5.7。随机方法提醒我们:动态本身不够,关键是动态地选对维度。
RMM 在 Transformer 里到底切哪里
把所有矩阵乘都写成 A × B 以后,Transformer 里的很多计算都可以放进同一个框架。
在线性投影和 MLP 里,A 是当前 hidden states,B 是权重矩阵。RMM 选择 hidden dimension 的一部分,只计算对应的输入通道和权重行。
在注意力里,情况稍微多一层。
计算 attention score 时,模型做的是 QKᵀ。这里可以沿 attention head 的 feature dimension 选维度:看当前 Q 在哪些 head 维度上能量更大,只用这些维度去和 K 相乘。
计算 attention output 时,模型做的是 PV,P 是 softmax 后的 attention weights。这里的收缩轴是 token 位置。RMM 可以对 token 维度做选择:看 P 在哪些历史位置上的范数更大,只让这些位置的 V 参与输出。
这就把 RMM 和常见的 activation sparsity 区分开了。像 TEAL 这类方法主要稀疏化投影层输入激活;RMM 的覆盖范围更宽,它可以进入 QKᵀ 和 PV 这两个 attention 内部矩阵乘。也就是说,它不是只在层与层之间切 hidden state,而是在矩阵乘本身的收缩轴上动刀。
这一步很重要,因为长上下文场景里的大头成本并不只来自权重投影。随着序列长度增长,attention 内部的 QKᵀ 和 PV 会越来越重。如果一个方法只能切固定权重维度,却不能碰 attention 内部乘法,它在长上下文里的收益就会被限制住。
规模越大,通常越能忍,但不是无条件
论文最容易被误读的一句话是:更大的模型更能容忍 RMM。
这个趋势确实存在,但它不是一条铁律。
在主实验里,研究者测试了 Qwen3.1 7B、LLaMA 3.1 8B、Qwen3 32B、LLaMA 3.1 70B,并在 RR=0.9 到 RR=0.5 间扫描。任务包括 COPA、ARC、PIQA、CommonsenseQA、GSM8K、MMLU、HumanEval。
我们看几个具体数字。
LLaMA 3.1 8B 在 RR=0.8 时,COPA 从 77.2 到 77.2,ARC-E 从 76.3 到 75.1,PIQA 从 79.9 到 79.1,看起来很稳。但 GSM8K 从 26.2 到 23.7,MMLU 从 63.5 到 60.3,已经能看到推理任务的敏感性。到 RR=0.5,GSM8K 只剩 5.9,MMLU 24.8,说明“保留一半”对复杂任务不是免费午餐。
Qwen3 32B 在相同设置下更稳一些。它的基线 GSM8K 是 62.6,RR=0.8 时 58.0,RR=0.5 时还有 39.9;MMLU 从 80.8 到 78.6,再到 65.1。70B 也体现出类似的缓降趋势,但并非所有指标都更好。例如 LLaMA 3.1 70B 的 HumanEval 在 RR=0.8 从 51.2 降到 47.0,到 RR=0.5 降到 18.9。
所以更准确的说法应该是:规模增大通常带来更多可约冗余,使中等强度减少更安全;但任务、模型家族、组件位置和 retention ratio 都会改变边界。
这也是论文的一个优点。它没有把 RMM 包装成“通用无损加速”。相反,它用保留率扫描把可约性画成了一条曲线:前面很平,后面会出现拐点。工程上真正有用的不是知道 RR=0.5 能不能跑,而是知道自己的模型和任务在哪个 RR 之后开始明显失真。
最关键的边界:注意力侧松,MLP 侧硬
如果只看平均指标,我们会以为 Transformer 里到处都有差不多的冗余。
论文的组件分析推翻了这个直觉。
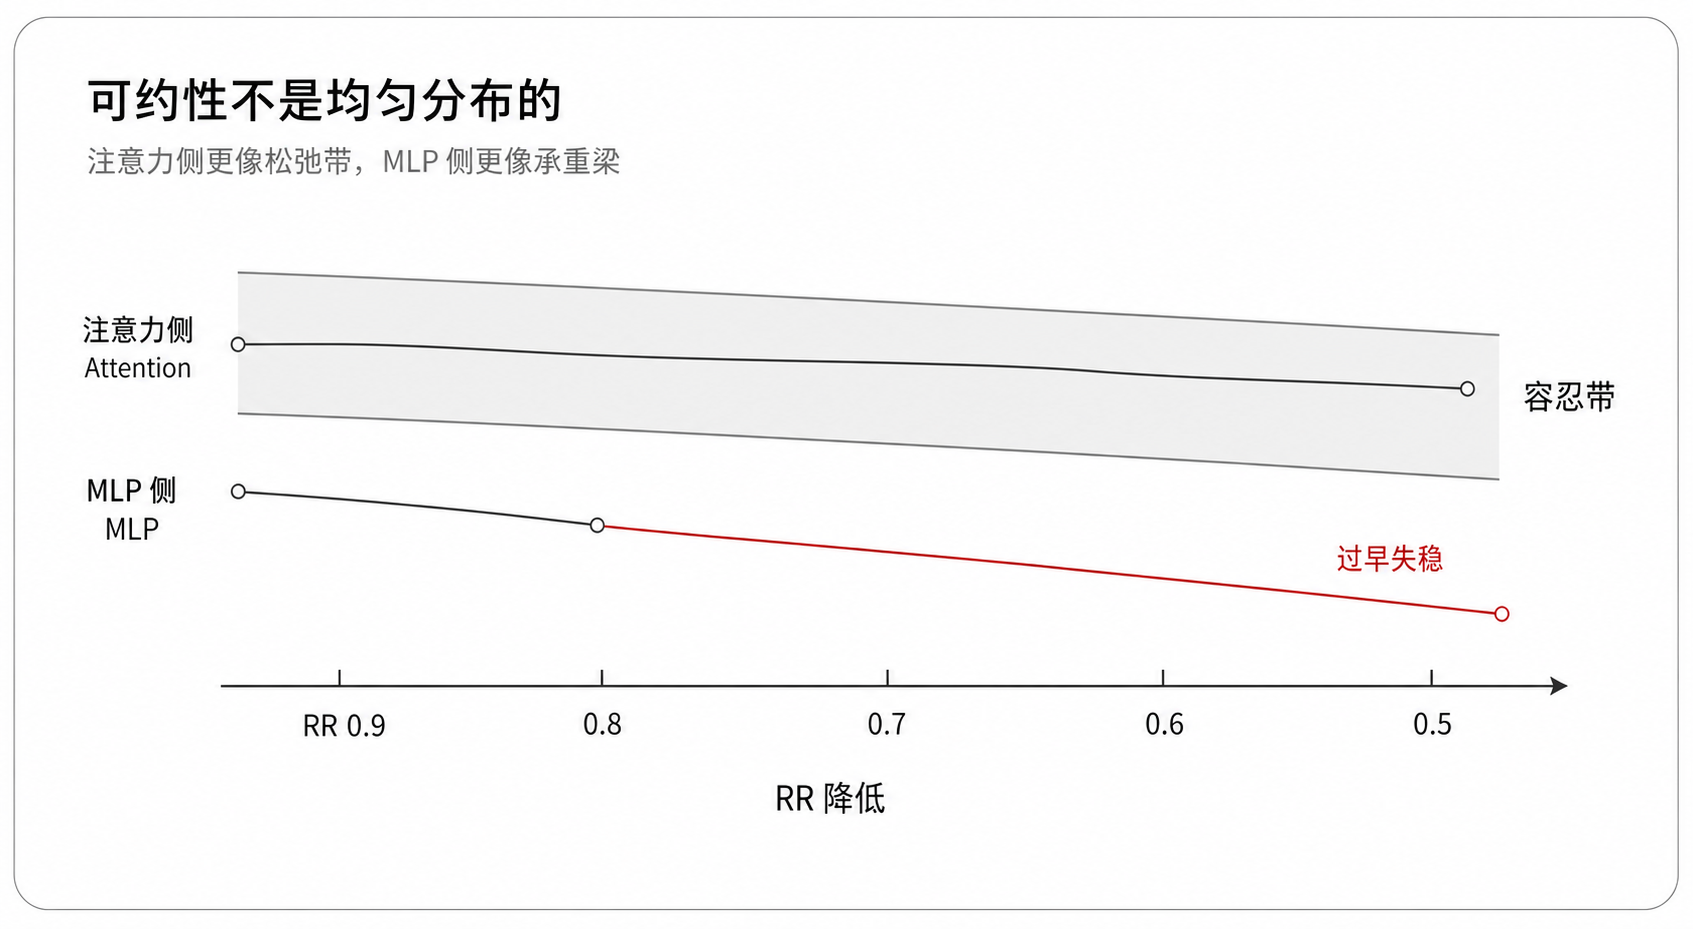
研究者在 LLaMA 3.1 8B 上分别对 attention-side 和 MLP-side 的不同矩阵乘做 RMM。结论很清楚:注意力侧计算更容易被减少,MLP 侧更敏感,而且 MLP 内部不同投影也不一样。
在一个 compute-normalized 的组件分析里,ARC-Easy 基线是 76.32。RR=0.7 时,attention-side full reduction 得到 72.80,只掉 3.52 点,保留激活能量 89.69%。MLP Up 得到 60.00,掉 16.32 点,保留能量 82.24%。MLP Gate 掉 7.20 点。MLP Down 只掉 3.51 点,保留能量高达 99.02%。整个 MLP 一起切,则掉 18.78 点。
这些数字讲了两件事。
第一,attention 里确实有更多可替代、可冗余的计算路径。只要保留当前输入里最强的那些维度或 token,很多任务上的输出还可以维持在相近区域。
第二,MLP 不是一个可以整体粗暴打折的模块。Up、Gate、Down 三个投影承担的功能不同,误差也会以不同方式积累。即使某个单独投影看起来还能承受,整个 MLP 一起减少时,误差会叠加成更大的能力损失。
这对实际部署很有启发。RMM 的最稳妥入口不是“所有矩阵乘一律保留 80%”,而是优先在 attention 内部和 QKV 相关路径上试,再对 MLP 采用更保守、更组件化的策略。
长上下文和多模态:边界外推到哪里
一个训练-free 方法最怕只在选择题上好看。论文因此做了两个更接近真实推理的检查:长上下文和视觉语言模型。
长上下文用 Ruler 的 CWE 和 Hotpot。结果很有意思:在测试的范围里,RMM 没有随着上下文变长出现系统性恶化。CWE 上,完整模型在 5K、15K、30K 的结果是 98.2、94.0、29.6;RR=0.8 是 98.1、94.1、29.3;RR=0.5 是 98.0、94.0、28.9。Hotpot 上,完整模型是 53.6、56.4、51.2;RR=0.5 是 53.6、55.6、50.5。
这不等于 RMM 已经证明能覆盖所有长上下文任务。Ruler 的这些子任务只是一个窗口。但至少它说明,在这个实验设定里,减少 attention-side 的收缩维度没有明显破坏长程依赖。
多模态实验用的是 Qwen 2.5-VL-7B。POPE、BLINK Art Style、Forensic Detection、Counting 上,完整模型分别是 83.7、100.0、100.0、100.0。RMM 在 RR=0.8 下是 82.0、100.0、100.0、100.0;在 RR=0.5 下仍有 67.3、97.4、97.7、99.2。相比之下,随机 pruning 在 RR=0.5 下 POPE 只有 1.3,几个 BLINK 指标也明显崩掉。
论文还展示了第一输出 token 的 attention map:RMM 仍能关注到相关视觉区域,而静态和随机方法更容易散掉。这个证据是定性的,但和表格方向一致:RMM 不是只在文本 hidden dimension 上偶然有效,它的“按当前激活选择收缩轴”原则可以迁移到视觉语言推理。
不过边界也要说清楚。论文自己承认,它没有详细研究视觉语言模型不同组件的冗余模式。图像 token、文本 token、跨模态对齐层之间的可约性是否相同,还没有被系统拆开。
省下的 FLOPs 是否真的变成时间
很多推理优化看起来能省 FLOPs,但落到 GPU 上未必变快。原因很现实:TopK 有开销,gather 有开销,kernel 不够融合也有开销。尤其 batch size 小、序列短时,选择成本可能吃掉理论收益。
所以论文做了 A100 wall-clock 测试。
kernel 级别,在 LLaMA 3.1 8B、ρ=0.8 下,序列长度 1024 时,QKᵀ 从 0.120 ms 到 0.089 ms,1.36×;AV 从 0.065 ms 到 0.039 ms,1.67×。到 4096,QKᵀ 从 1.675 ms 到 1.071 ms,1.56×;AV 从 0.753 ms 到 0.399 ms,1.89×。
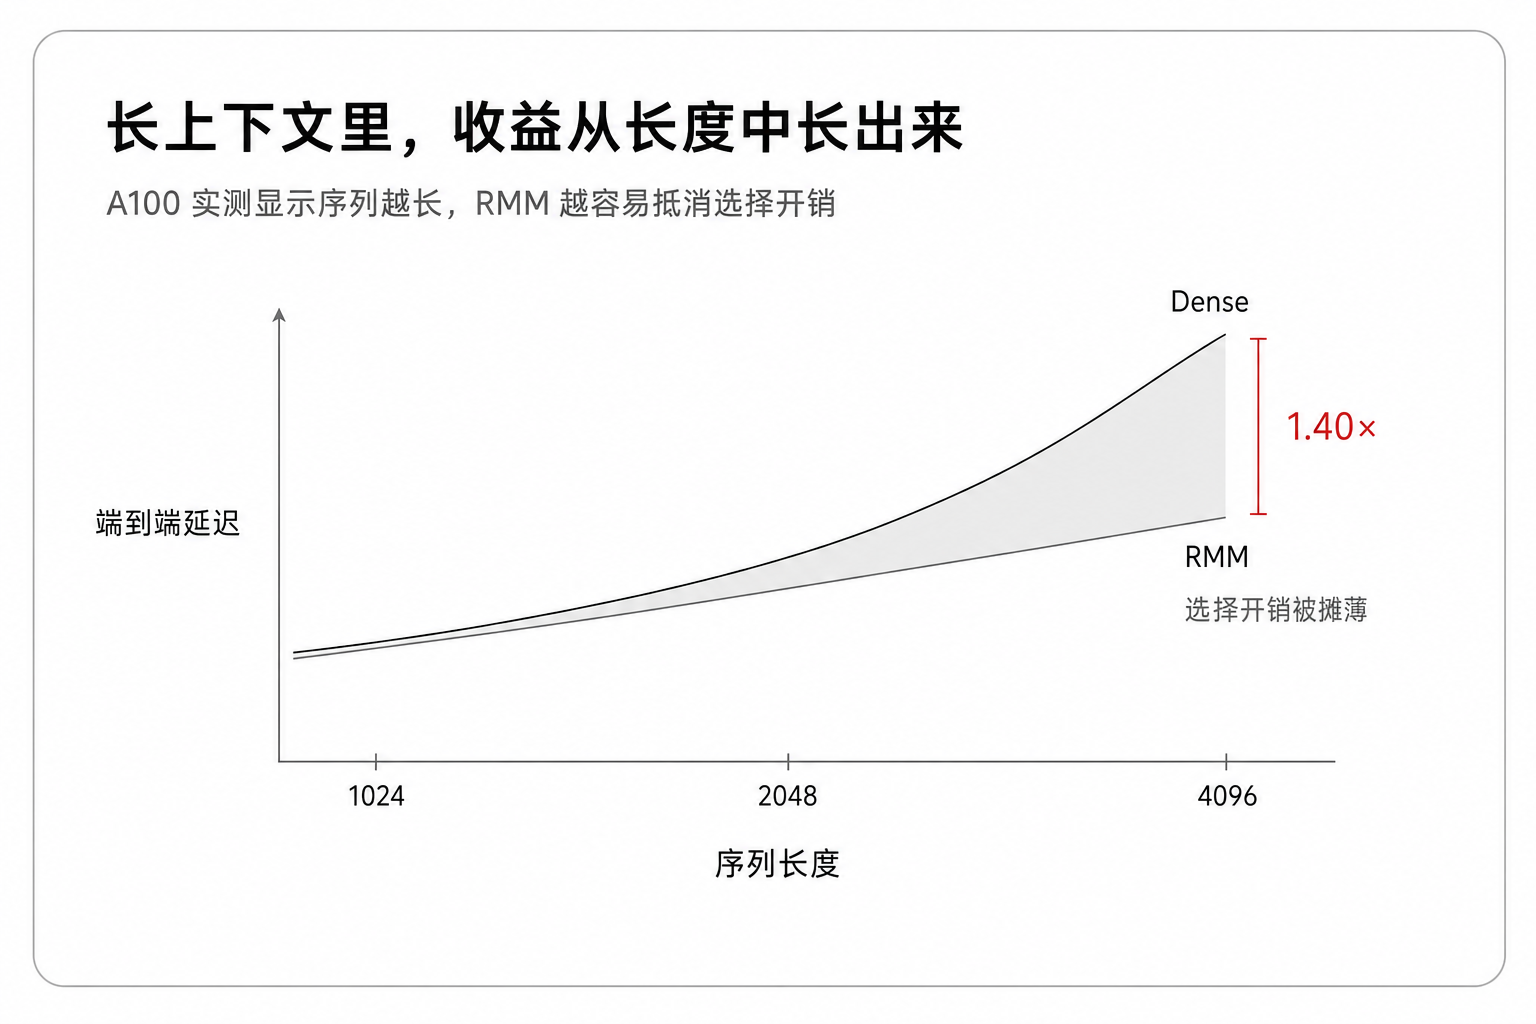
端到端就更保守,也更接近真实。batch size 1,A100,ρ=0.8,所有数字取 10 次平均。序列长度 1024 时,dense 是 109.39 ms,RMM 是 103.91 ms,只是 1.05×。到了 2048,是 264.67 ms 对 208.93 ms,1.27×。到了 4096,是 661.36 ms 对 473.21 ms,1.40×。
这个结果的含义很清楚:RMM 的实际收益来自长序列把选择开销摊薄。短上下文里,它可能只是小幅变快;长上下文里,attention 矩阵乘越来越重,保留率减少才更容易变成真实 latency gain。
这篇论文证明了什么,没有证明什么
RMM 证明了四件比较扎实的事。
第一,Transformer 推理里的矩阵乘收缩轴确实存在可减少空间。这个空间不是固定维度集合,而是要随当前输入、层、head 和解码步骤变化。
第二,在不少任务上,中等保留率可以维持相近表现。LLaMA 3.1 8B 在 RR=0.8 下多个 QA 指标接近完整模型,CNN/DailyMail 摘要几乎不掉;长上下文 Ruler 子任务在 RR=0.5 也没有系统性恶化。
第三,可约性分布不均匀。注意力侧比 MLP 侧更适合先做 RMM;MLP 内部不同投影也有不同敏感度。这个结论对工程策略比“平均加速多少”更重要。
第四,至少在 A100 和自定义 Triton kernel 的设定下,计算减少可以转成实际 wall-clock 收益,并且序列越长越明显。
但它没有证明另外几件事。
它没有证明 RMM 是无损优化。RR=0.5 在 GSM8K、MMLU、HumanEval 等任务上会明显掉点,小模型尤其敏感。
它没有证明一个 retention ratio 可以通吃所有模型和任务。论文反复显示,模型家族、规模、任务和组件都会改变拐点。
它也没有证明训练-free 是最终形态。现在的 RMM 选择规则很干净,便于解释和部署;但未来如果允许轻量校准、组件级策略搜索、甚至和量化/稀疏 kernel 联合设计,边界可能还会移动。
最值得带走的,不是“RMM 可以让 LLM 推理加速 1.40×”这句单点结论。
更重要的是一个视角:Transformer 的推理成本不是一整块铁板。每个矩阵乘都有自己的收缩轴;每条轴上都有当前输入激活出的能量分布;不同模块对切掉低能量部分的容忍度不同。RMM 把这个结构性差异显性化了。
当我们以后再谈 LLM 推理优化时,也许不该只问“哪些 token 可以删”“哪些权重可以量化”。还可以多问一句:这一次乘法里,哪些维度真的需要参与求和?
如果答案随输入而变,那么优化器也应该随输入而变。