LittleLearner:把大模型的知识边界画在训练之前
一个模型答不出“薛定谔的猫”,通常有两种解释。
第一种解释是它其实见过,只是这次没调出来。提示词不对,采样不巧,或者答案藏在参数里但没有被激活。我们换几个例子,做一点 SFT,甚至上 RL,也许它就会突然“想起来”。
第二种解释更朴素:它从来没有真正学过这个概念。它会说话,会组织句子,也会把陌生词套进熟悉的解释模板里,但底层没有量子力学那个结构。于是它给出的不是沉默,而是一个听起来像解释的错解释。LittleLearner 在论文的例子里就把 Schrödinger’s cat 说成“一只有两张脸的猫”。
这篇论文的价值,不在于又训练了一个 5B 小模型。它真正做的是把这两种解释分开:如果我们能在预训练开始前就规定模型只能接触小学 K–5 范围内的语言、事实、数学和概念,那么当它后来碰到 K–5 之外的任务时,我们就不必再猜“它是不是在背训练集”。
我们第一次拥有的不是一个更强的模型,而是一个边界更清楚的模型。
先把几个概念说清楚
想象我们要研究一个学生能不能靠“举一反三”学会代数。最糟糕的实验设计,是先让这个学生随便上网看十年资料,然后再问他一道代数题。答对了,我们不知道他是在推理,还是以前刚好看过类似题;答错了,我们也不知道是没学会,还是题目问法不合适。
大语言模型也是这样。今天的大模型是在巨大、混杂、无法完全审计的网页语料上训练出来的。它们的知识边界不是一条线,而是一团雾。我们只能在训练后做 benchmark,尽量找“没污染”的题。但只要训练语料不透明,评测永远带着一个疑问:这到底是新能力,还是旧知识被唤醒?
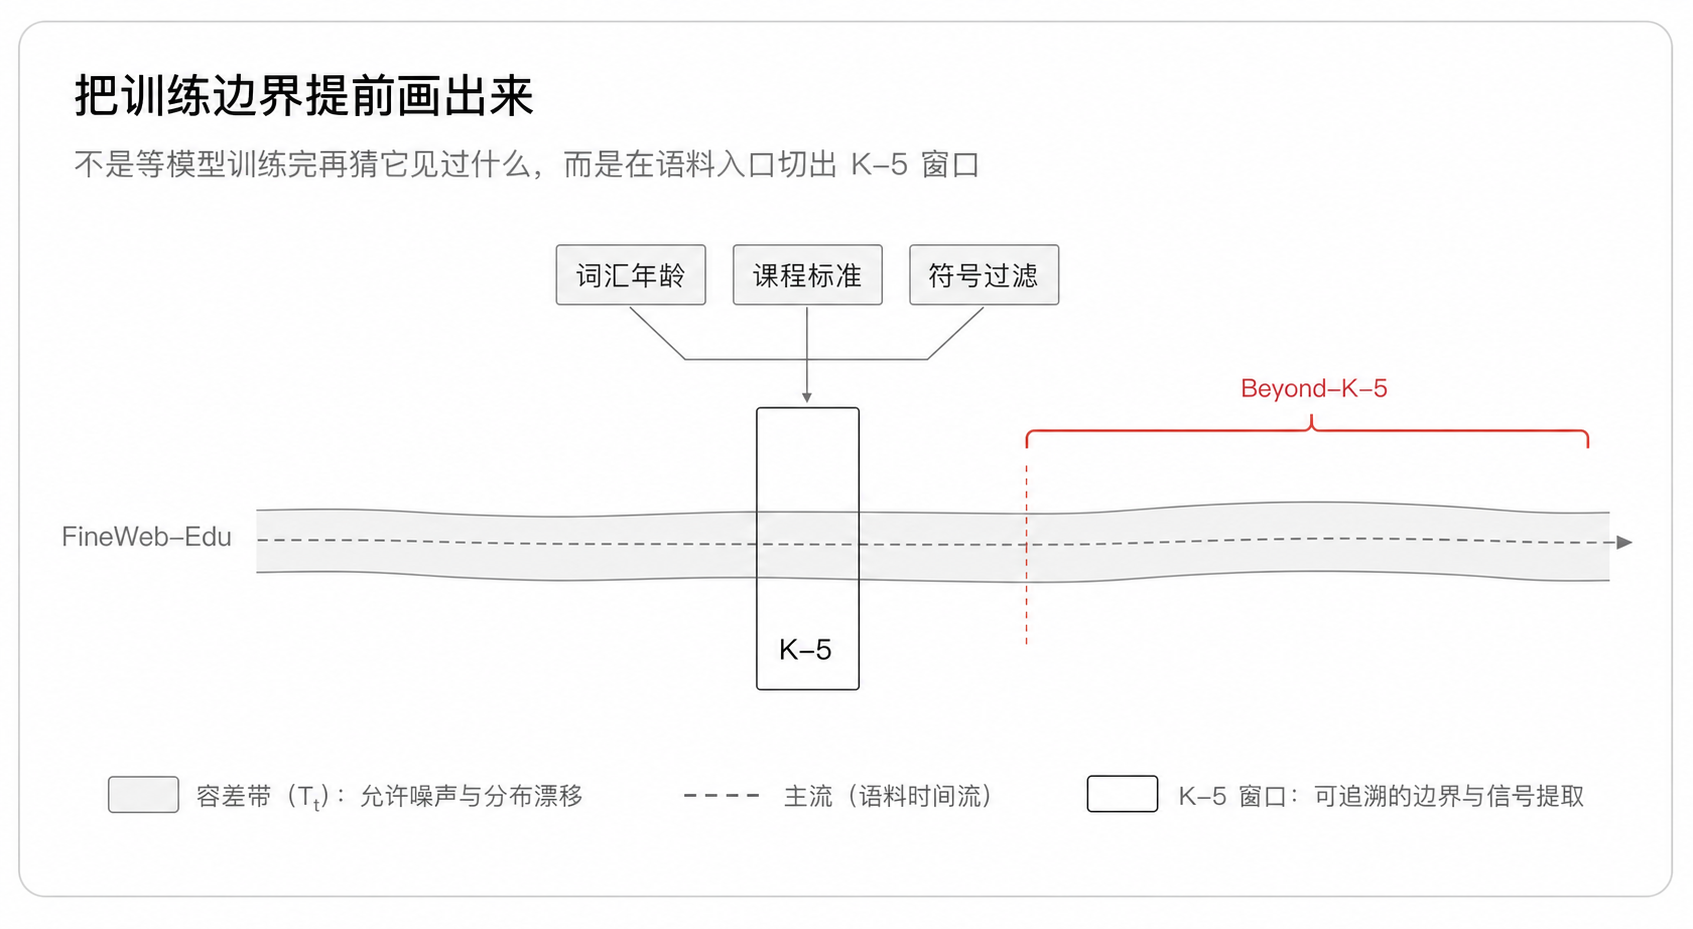
LittleLearner 反过来做。研究者不是先训练一个模型再去测边界,而是先造一个叫 LittleCurriculum 的训练语料:从 FineWeb-Edu 里过滤出大致对应美国小学 kindergarten 到 Grade 5 的材料,显式排除 Grade 5 以上才教的概念、事实、词汇和符号。然后在这个语料上从零训练一个 5B 参数模型。这个模型就是 LittleLearner。
这里的“课程”不是说模型像小学生一样学习。论文也很谨慎地强调,LittleLearner 不是一个数字儿童。人类孩子学数学靠课堂、身体经验、互动反馈;模型学的是 token 分布。K–5 只是一个可解释的暴露边界:哪些概念可以出现,哪些概念原则上不该出现。
有了这个边界,后面的问题才变得干净:规模变大,能不能越界?GRPO 后训练,能不能把训练外能力补回来?给 few-shot 示例和解释,能不能临时教会它?
这条边界是怎么切出来的
如果只是拿一个可读性公式筛网页,边界会很脆。很多高级概念可以用简单句子写出来;很多小学材料也可能句子很长。LittleCurriculum 的过滤管线因此是多层的,而且故意保守。
第一层先用 Age-of-Acquisition,也就是词汇通常在什么年龄被习得,做粗筛。FineWeb-Edu 里约 10% 的词没有 AoA 覆盖,论文用 WordFreq 的 Zipf 频率去补缺失值。规则也不是看见一个高级词就扔掉,而是当一段文本中超过 5% 的词超过目标年龄 12 岁时才丢弃,避免单词噪声过度影响。
第二层更贵。研究者用 Gemini 3 Flash 做 LLM-as-a-judge 标注,把文本分到 elementary、middle school、high school、out-of-scope 等等级,再训练 FastText 和 ModernBERT 分类器。为什么不直接让 LLM 标完整个 FineWeb-Edu?论文给了一个很现实的数字:按 Gemini Flash 价格,全量标注约 6.95B 个样本要接近 4587 万美元。过滤管线本身也是一种成本工程。
第三层专门处理符号。高级数学有时不靠复杂词汇,而靠形式符号泄漏:求和号、积分号、偏导、指数、根式、多变量方程。论文用规则表达式扫这些结构化符号。这个阶段只多删掉约 0.1% 的剩余文档,但它的意义不是大规模筛数学,而是清掉分类器最容易漏掉的符号尾巴。
最后,候选池仍然大约有 100B token,超过 80B 的训练目标。研究者没有均匀抽样,而是用 Beyond-K–5 中过度出现的词做频率采样,再向内收紧。最终得到的 LittleCurriculum 是 88B token,包含常规预训练数据和训练后期的 K–5 约束改写数据。
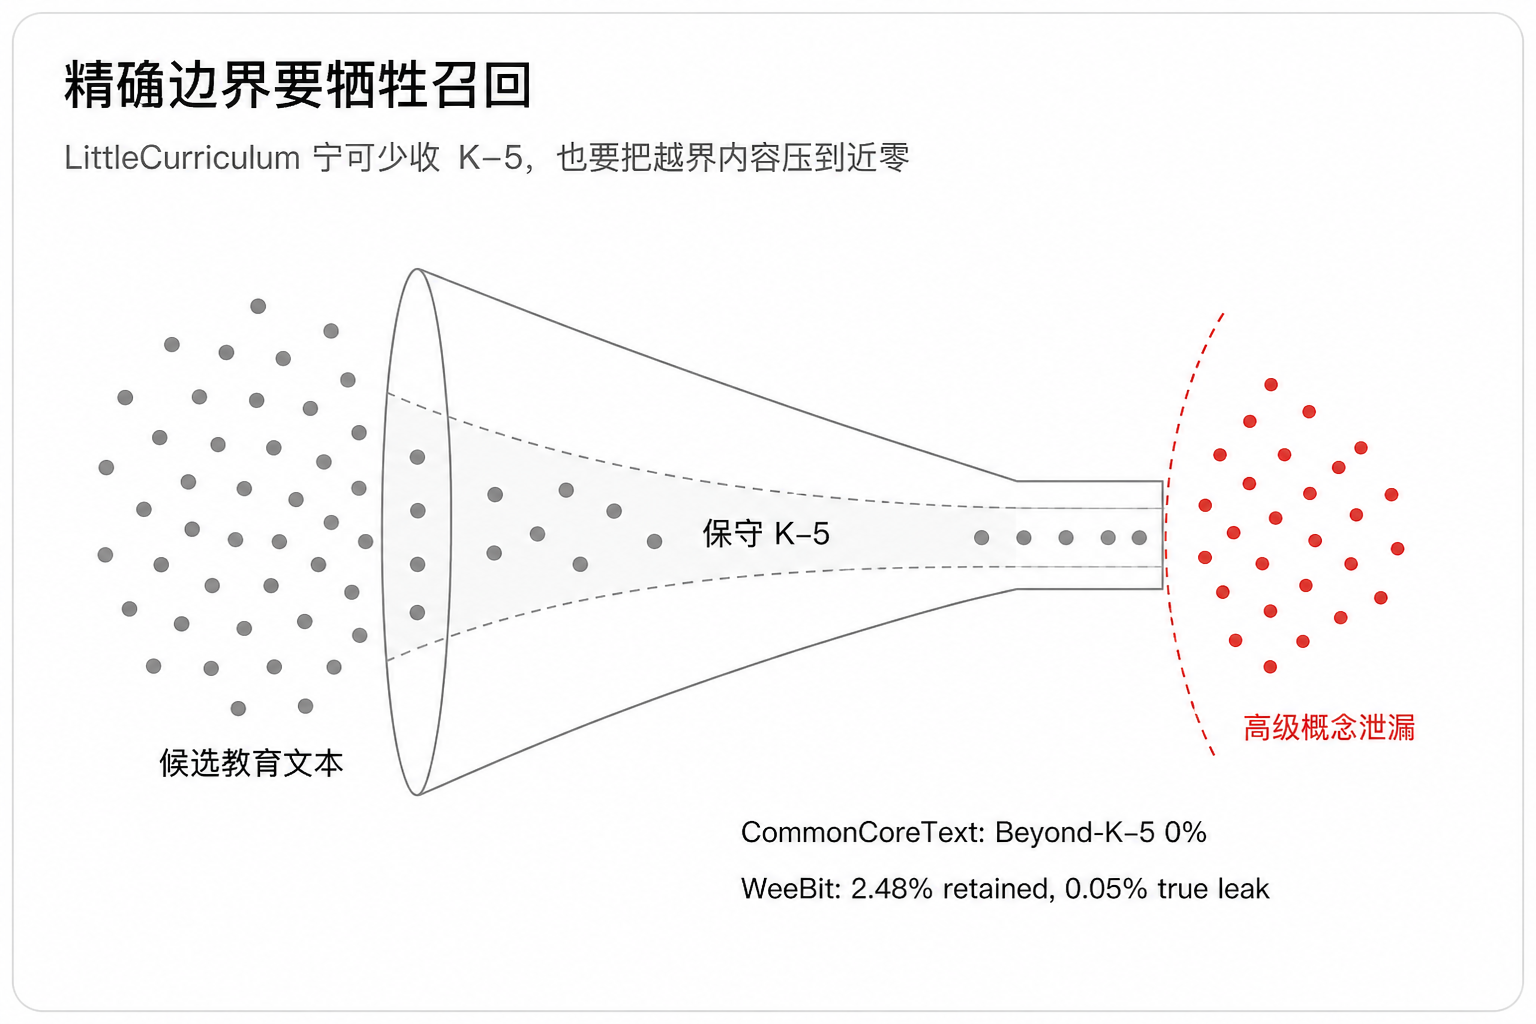
这套过滤不是追求“收集所有小学材料”。它追求的是边界可信。
证据也围绕这个目标展开。在 CommonCoreText 这个由课程材料和阅读文本构成的 held-out 数据上,管线把 Beyond-K–5 保留率压到 0%,同时只保留约 35% 的 K–5 材料。这个 35% 看起来低,但正是论文的选择:宁可错杀大量真正的小学材料,也不要把高级概念混进来。
外部检查用的是 WeeBit。它有 6000 段 Beyond-K–5 文本,过滤后保留 2.48%。研究者人工看这些保留下来的文本,发现真正含有越界概念的只有 3 段,约占 Beyond-K–5 split 的 0.05%;其余多是网页抓取噪声或教育价值不明确的内容。论文还用 126 个来自课程标准的 Grade-6+ n-gram 扫描保留语料,只有 0.09% 的 passage 命中。
这些数字不能证明语料绝对无泄漏。它们证明的是:LittleCurriculum 的边界比普通 web-scale 预训练语料清楚得多,足够作为一个受控沙盒。
一个会说话、但没见过高级课本的模型
LittleLearner 按 Qwen3 dense 架构,从零训练,规模 5B,训练用了 8 张 NVIDIA B200,大约 100 小时。对照组很关键:Unfiltered 使用相同模型类型和训练 recipe,但训练在未经过 K–5 过滤的 FineWeb-Edu 上。这样,很多差异就不能简单归因于架构或优化器,而更容易指向训练暴露本身。
论文先验证模型真的呈现出“见过 K–5、没怎么见过 Beyond-K–5”的样子。
语言上,研究者用 CLEAR 数据集看不同难度文本的 bits-per-byte。LittleLearner 对更难文本的 BPB 稳步上升,说明它越来越不熟悉;Unfiltered 和 Gemma 2B 则相对平坦。数学语言上,CoMTA 的学生辅导对话也呈现类似趋势:K–5 数学片段上 LittleLearner 和参照模型接近,Beyond-K–5 上明显陌生。
能力上,论文把 Jeopardy science 问题按 NGSS 课程范围分成 K–5 和 Beyond-K–5。LittleLearner 在 K–5 科学问题上还能回答,越过范围后突然下滑;Unfiltered 则跨两个 bin 更稳定。MathCAMPS 数学评测也一样:K–5 内部还可比,但到更高年级,LittleLearner 的表现更快塌下去。
最有意思的是定性例子。问“What is gravity?”,LittleLearner 回答“gravity is the force that pulls everything down”,简单但基本对;Unfiltered 会给出更物理化的反平方关系。问“What is DNA?”,LittleLearner 说 DNA 是“告诉我们长大后会是什么样子的指令”,有一点小学生化的影子,但不完整。问 “E = mc²” 时,它甚至会把它解释成一个数学常数和星球大战角色的名字。
这不是随机胡言乱语。它更像一个只学过有限概念的人,把陌生对象硬塞进熟悉模式里。
规模能不能把边界推开?
直觉上,我们可能会想:如果知识边界只是小模型容量不够,那把模型做大一点,也许它就能从 K–5 材料里抽象出更高级的规则。比如没见过正式代数,也许能从很多算术题里归纳出一些代数结构。
论文专门做了这个实验:在同一个 LittleCurriculum 上训练 0.6B、1.3B、5B 三个 LittleLearner,并在 MathCAMPS 上按年级看表现。
结果不是“规模完全没用”。在 K–5 内,规模提升确实带来明显收益;在 Grade 6、Grade 7 这种靠近边界、仍然和 K–5 算术共享结构的地方,也有一点外溢。论文甚至观察到,在最小规模时 LittleLearner 有时比 Unfiltered 更专注:因为有限容量没有被高中代数、微积分等材料分散,反而能把小学范围内的推理轨迹学得更集中。
但真正越界的地方不动。到 Grade 8,LittleLearner 在 0.6B、1.3B、5B 三个规模上都接近地板。论文的判断很直白:scale operates only within the exposure。规模像是把已经见过的课程讲得更熟,不像自动赠送下一册教材。
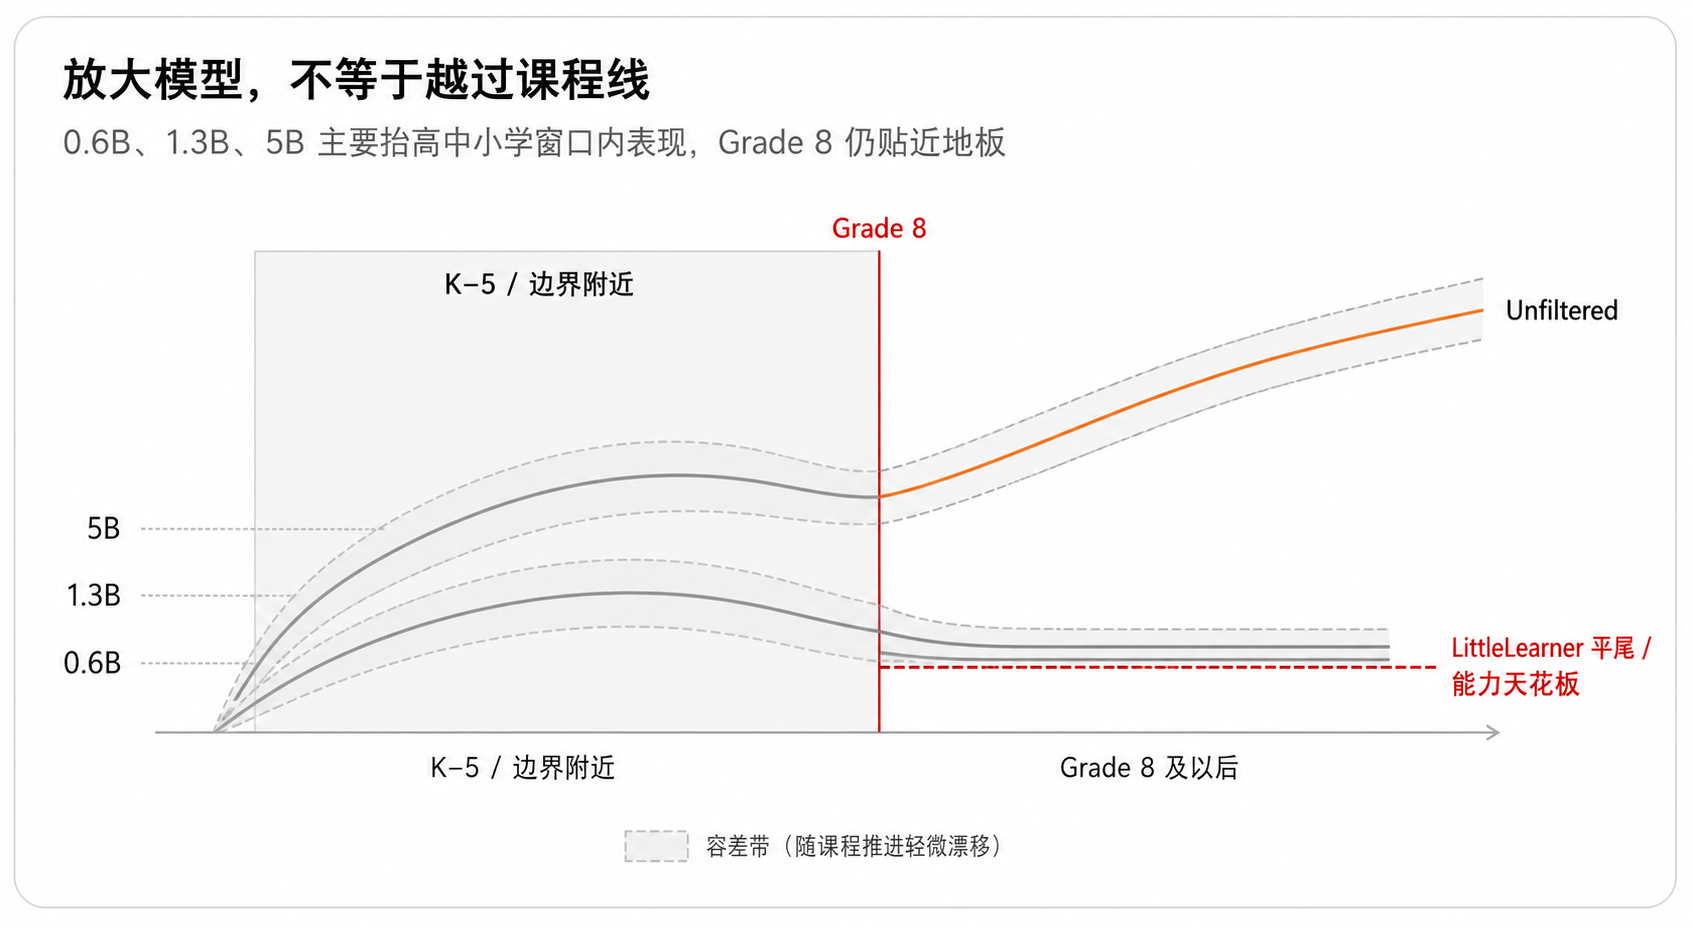
这里需要注意一个边界。论文不是说“大模型永远不能外推”。它只是在这个 K–5 语料、这些模型规模、这些 MathCAMPS 任务上显示:参数量增加主要提高训练范围内和边界附近表现,不能可靠生成训练外高级数学能力。
这个结论之所以重要,是因为它给“涌现能力”讨论加了一个干净参照。如果标准 web-scale 模型在某个任务上随规模突然变强,我们很难知道是算法外推还是大模型终于有容量记住/重组训练中稀疏出现的相关材料。LittleLearner 的设定让这种问题可被更直接地测试。
后训练和上下文学习,更像放大器
第二个直觉是:预训练没见过不要紧,后训练可以补。现在很多 reasoning 模型的故事都是 SFT 加 RL,尤其 GRPO 一类方法常被看作能激发推理能力。
论文做了两阶段后训练:先 SFT,再 GRPO。LittleLearner 的 SFT 数据来自过滤后的 K–5 数据;Unfiltered 使用 compute-matched 的未过滤数据。GRPO 阶段还专门比较了 LittleLearner 在 K–5 问题和 unfiltered 对照问题上的训练。
结果很像前面的规模实验。K–5 内,后训练确实提升能力;Beyond-K–5 上,LittleLearner 只有很有限改善,而 Unfiltered 的提升大得多,两者差距反而更明显。最关键的是,在论文测试预算下,LittleLearner 用 K–5 数据后训练和用 Beyond-K–5 数据后训练,没有观察到决定性差异。换句话说,短程 GRPO 不是把模型变成“没学过也会”的魔法。
第三个直觉是 in-context learning。既然模型能读 prompt,我们给它三个同类例题,再给一段手写解释,会不会临时教会它?论文为 MathCAMPS 每个 CCSS standard 合成三个新问题,并人工写自然语言 CoT 示例,也比较了 compact algebraic、Q/A only 等格式。
Table 5 很有代表性。对于 chat-tuned 的 LittleLearner 5B SFT,zero-shot direct 在 K–5 是 34.0%,Beyond-K–5 是 6.0%,平均输出 352 字符。自然语言 few-shot 把 K–5 提到 36.8%,但 Beyond-K–5 是 5.9%,几乎没有改善;compact algebraic 反而掉到 17.0% / 1.6%,Q/A only 只有 9.2% / 0.2%。模型会跟随示例改变输出风格和长度,但这不等于学会了新推理。
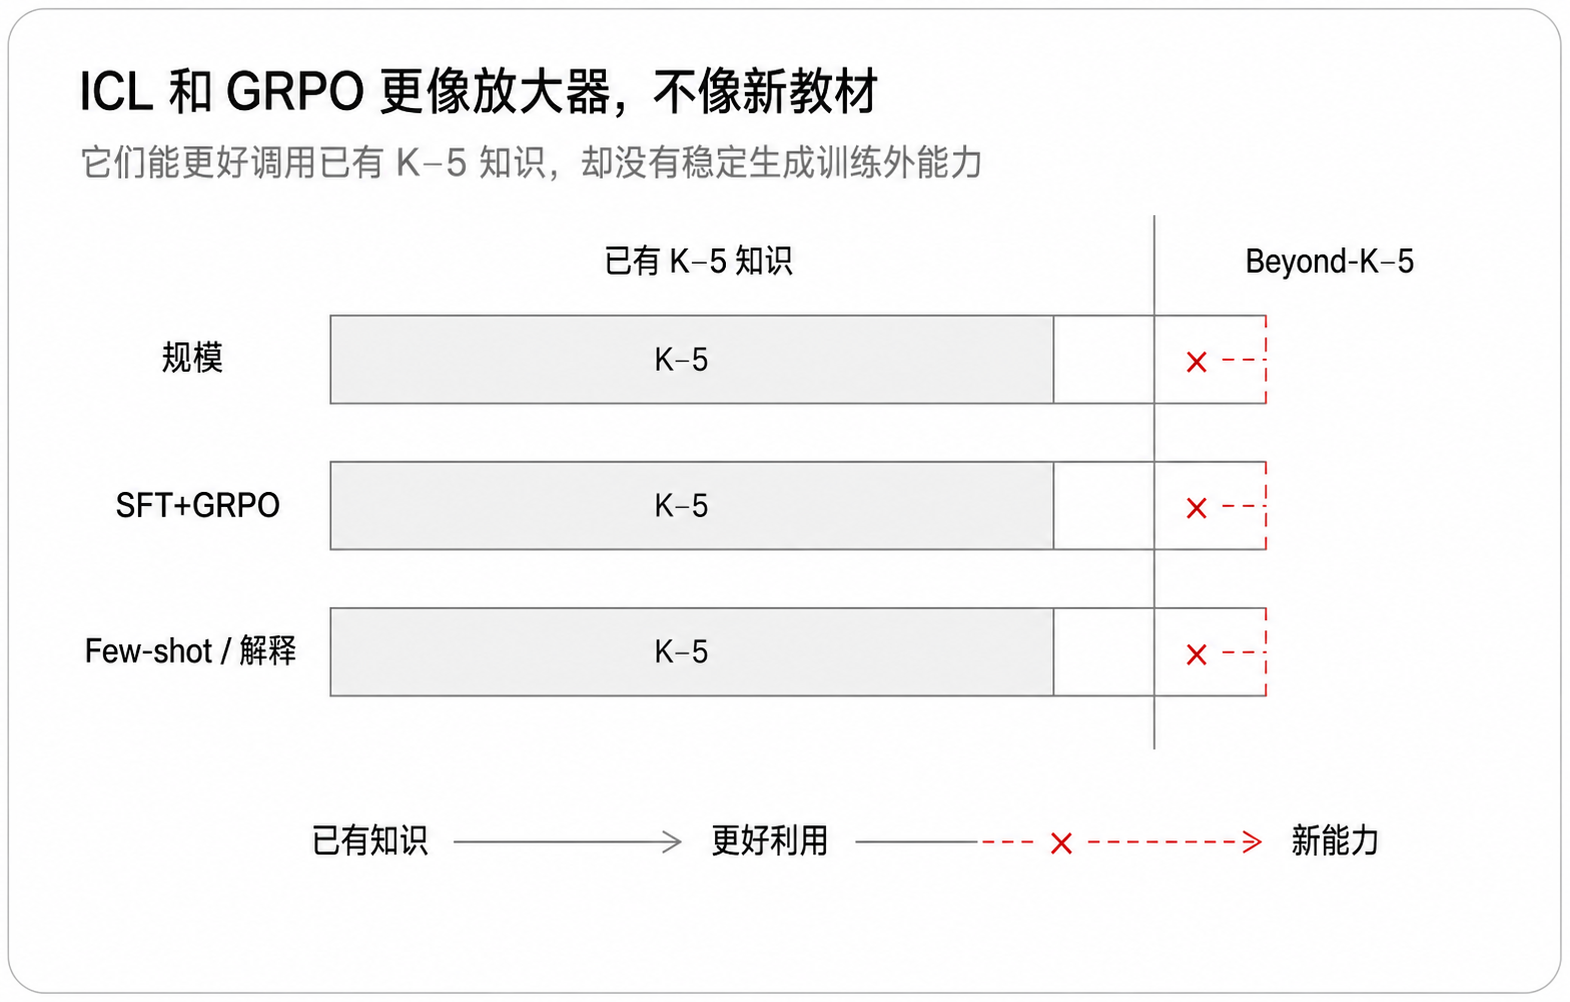
这组结果最好的读法是:ICL、SFT、GRPO 都可能更好地调用已有知识,也能把边界附近的能力整理出来;但在这个沙盒里,它们没有稳定把能力推到预训练暴露之外。
这篇论文真正证明了什么
它证明的第一件事,是“训练暴露可控”本身可以成为研究工具。LittleCurriculum 不是一个更通用的数据集,而是一个带教学边界的实验容器。它让我们能问:某个能力是在预训练中已经埋下,还是后来的算法真的创造出来?
第二,论文给出了一套相当强的边界核验证据:CommonCoreText 上 Beyond-K–5 保留率 0%,WeeBit 上 6000 段 Beyond-K–5 只保留 2.48%,人工判定真越界 0.05%,126 个高级 n-gram 命中 0.09%。这些数字不能当作绝对无污染证明,但足以支撑“相比普通 web-scale 语料,边界显著更可解释”。
第三,在作者测试的首批实验里,模型规模、SFT+GRPO、few-shot/解释都主要提高范围内表现或边界附近表现,没有把 LittleLearner 稳定带到 Beyond-K–5。尤其是 Grade 8 上,规模实验接近地板;ICL 的 Beyond-K–5 从 6.0% 到 5.9%,几乎没有收益。
但它没有证明三件事。
第一,它没有证明所有 RL 都不能产生训练外能力。论文测试的是特定预算、特定任务、特定 5B 级模型。作者自己也把 LittleLearner 看作未来研究 RL discovery、algorithmic extrapolation 的沙盒,而不是终局裁判。
第二,它没有证明 K–5 边界等同于人类儿童边界。论文明确说,人和模型的学习机制不同。LittleLearner 甚至会在某些“后置”技能上比“前置”技能表现更好,比如多位数除法路径并不严格跟随人类课程顺序。
第三,它没有证明所有知识泄漏都被排除。任何从网页过滤出来的 88B-token 语料都不可能做到数学意义上的完美隔离。可信的是多重检查后的低泄漏率,而不是绝对纯净。
为什么这件事值得关注
过去我们研究大模型,很像研究一个记忆混乱但极聪明的学生。它可能什么都见过一点,什么都记得一点,又什么都能组合一点。我们问它一道题,它答对了,但原因总在雾里。
LittleLearner 把问题改成了另一个形状:先规定学生只拿到一本到五年级为止的教材,再观察它能走多远。它不是为了得到最强学生,而是为了让“走多远”这件事有解释力。
这对未来很多问题都重要。比如 RL 到底是在发现新程序,还是在放大预训练里已有的程序?持续学习新概念时,旧知识会怎么干扰?模型什么时候应该说“不知道”,而不是把陌生概念翻译成熟悉错觉?这些问题在普通大模型上很难分清,因为训练史太乱;在 LittleLearner 这样的受控沙盒里,至少可以把变量一个个拿出来。
所以这篇论文的重点不是“小学语料训练出来的模型不懂高中内容”这个表面结论。真正的重点是:如果我们想研究模型如何获得新能力,第一步也许不是做更难的 benchmark,而是做一个边界更诚实的学习者。
当边界变清楚,所谓“学习”才终于不只是一个漂亮词。