把政府 API 真的跑起来:KOPA-Bench 与 EDGE 怎样教小模型学会多步工具调用
如果我们让一个智能体回答“某家公司最近披露了什么信息、相关证券数据有什么变化、最后请给我算一个比例”,它看起来只是在查几个 API。
但真正难的地方不在“调用 API”这个动作本身。
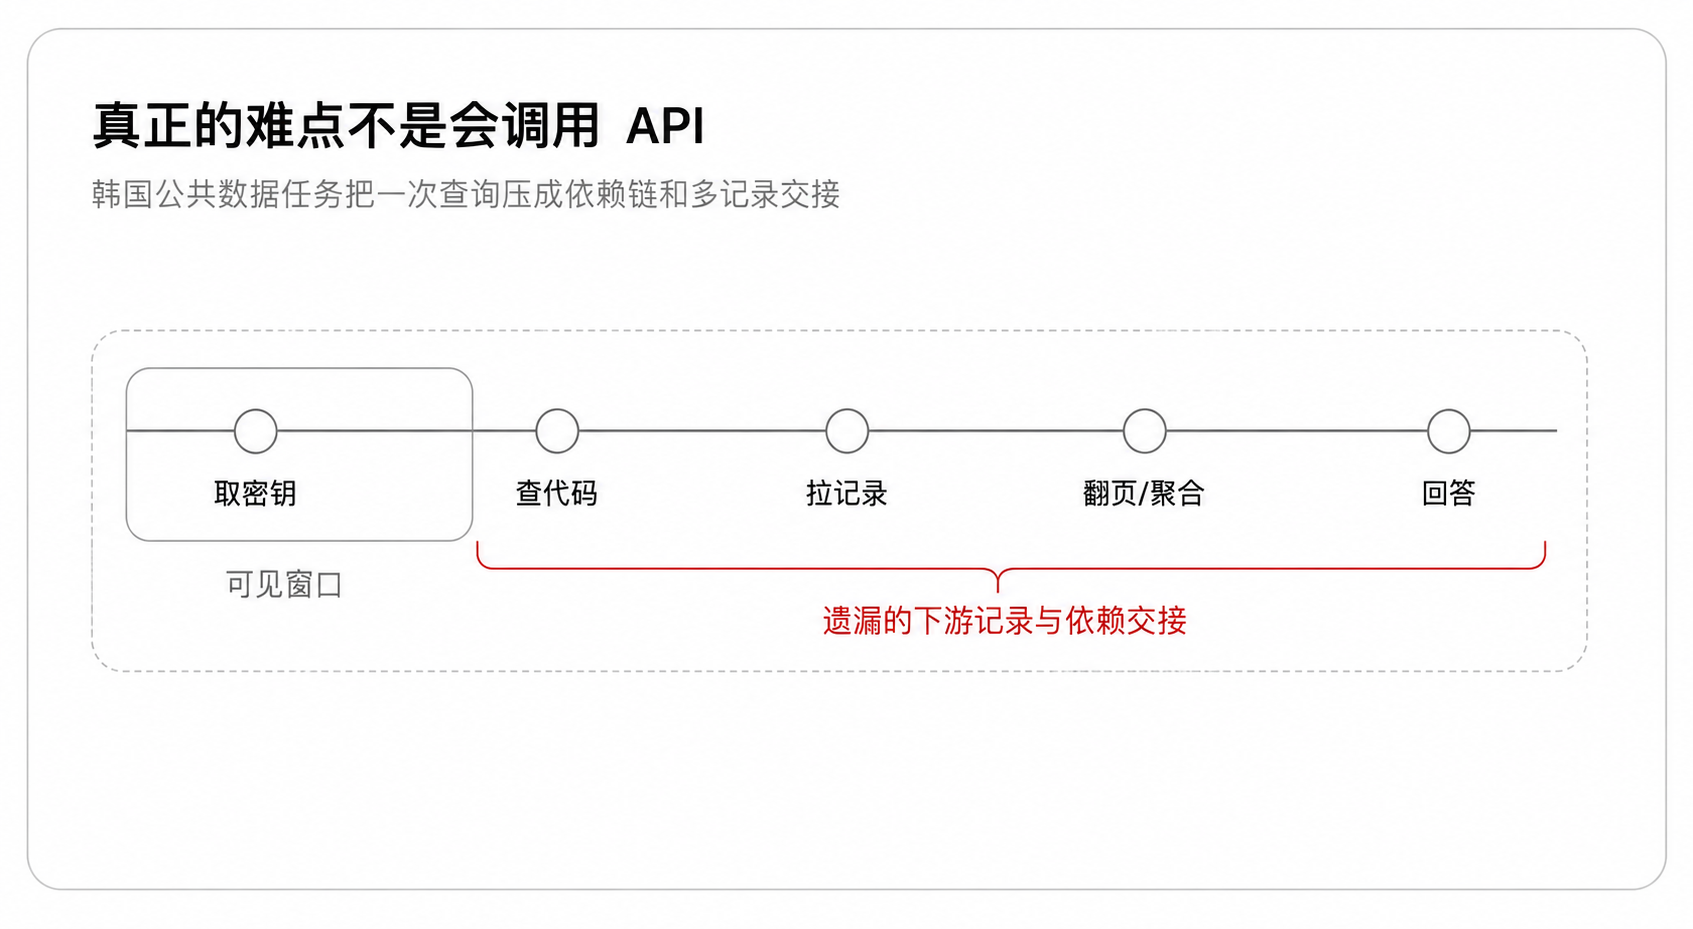
难的是第一步的输出,往往只是第二步的输入。公司名要先变成代码,代码再变成某个披露系统能识别的参数;一次查询返回的又不一定是一条记录,而可能是一页、一组、甚至几十万条候选。模型如果只看第一页就急着回答,表面上也调用了工具,结果却是错的。模型如果把一整片返回值直接塞给下游工具,轨迹又会变得含糊:到底应该传哪一个值?
这篇论文研究的就是这个更接近真实政务系统的版本:Multi-Step Tool-Calling over Korean Open Public APIs: A Benchmark and a Data-Synthesis Recipe。作者构建了 KOPA-Bench,一个覆盖韩国开放公共 API 的多步工具调用基准;又提出 EDGE,用真实 API 的执行结果去筛掉看似合理、实际跑不通的工具依赖,并合成可训练的多步轨迹。
先把几个概念走一遍
想象一个最朴素的办事流程。你要查某条高速公路的信息,系统不会直接接受“首尔附近那条路”这种自然语言。它可能先要求一个区域代码,再要求路段编号,最后才返回拥堵、事故或收费站数据。于是第一次 API 调用不是答案,而是在帮第二次调用准备钥匙。这个“上一步输出喂给下一步输入”的结构,就是论文里反复出现的工具依赖链。
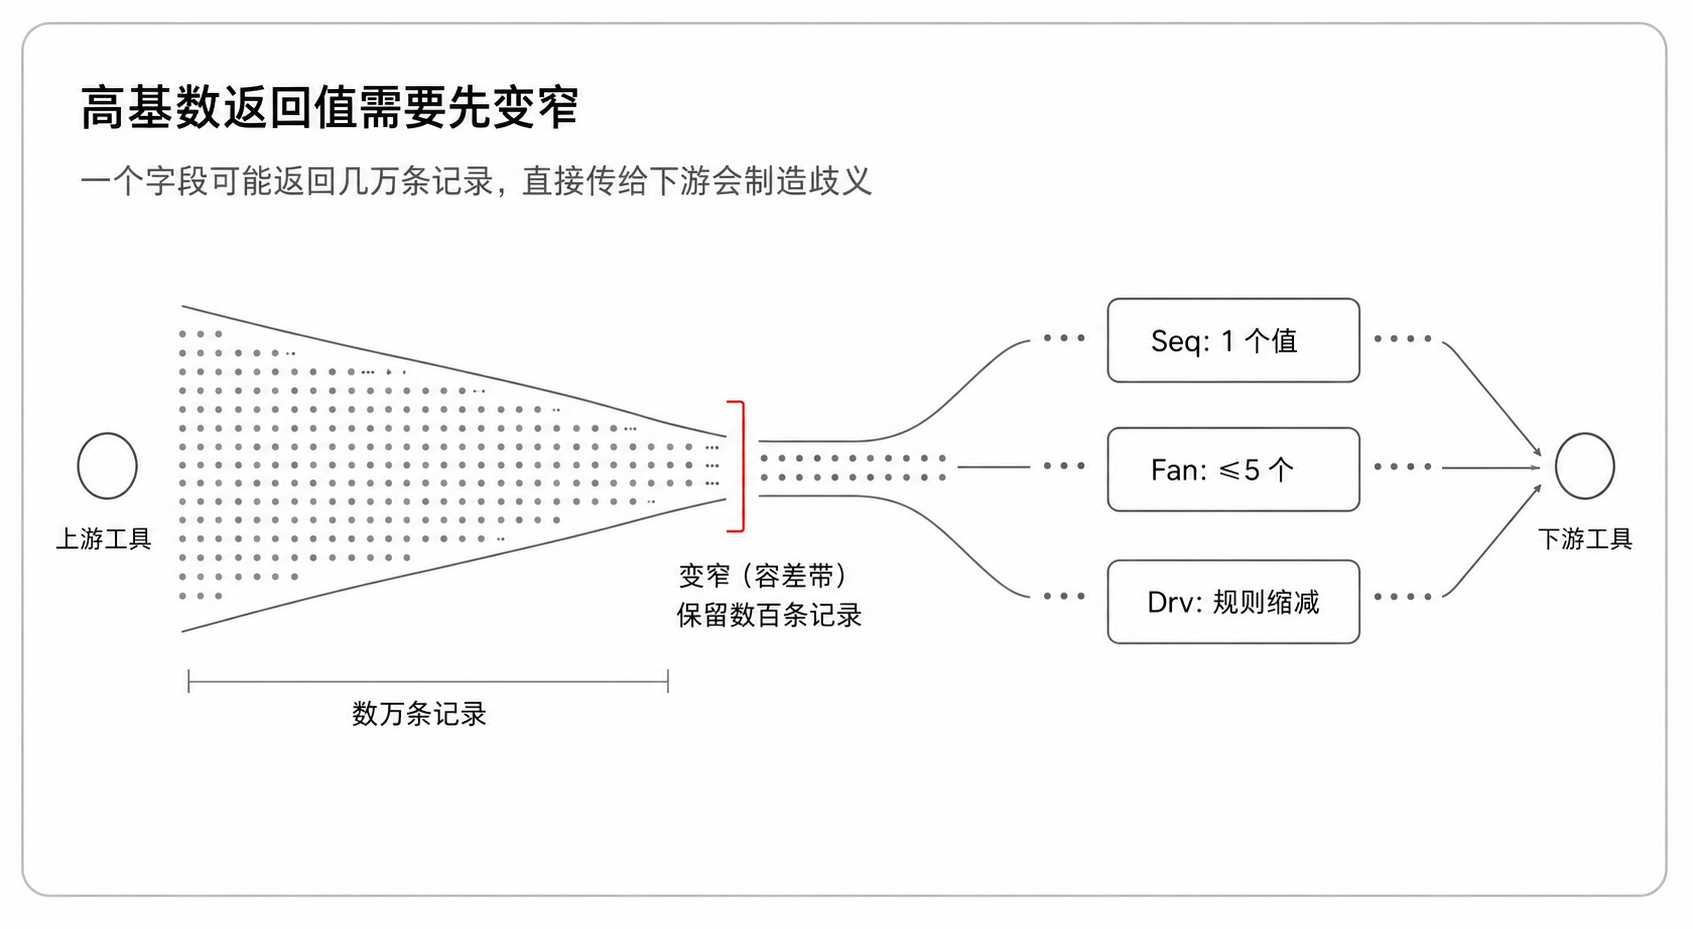
再看另一种情况。一个公共 API 返回的不是“目标学校”,而是所有候选学校;不是“某一条公告”,而是一大串公告。人会先缩小范围:取最新的、最高的、某日期之后的,或者把前五个候选逐个查下去。模型如果没有学过这种动作,就容易把多记录返回当成单值来用。论文把这个问题叫 high-cardinality handoff:高基数结果在工具之间交接。
最后是“执行接地”。一个 LLM 可以根据工具描述猜测:A 工具的输出字段看起来能填到 B 工具的输入参数里。但公共 API 很诚实——参数格式不对、代码体系不同、服务端状态变化,都会让这个猜测失败。EDGE 的核心直觉是:不要只相信语言模型判断这条边可行,要真的跑一次、跑很多次,让 live API 给证据。留下能执行的边,剪掉反复失败的边。
KOPA-Bench:把工具调用放回真实公共服务里
论文首先做了一件看似基础、但很关键的事:把测试场景从“模拟 API”推进到真实韩国公共 API。
KOPA-Bench 一共有 145 个任务,来自 10 个平台、6 个领域:交通、金融、教育、法律、政治、地区行政。表格里的分布很具体:交通 22 个任务,金融 29 个,教育 30 个,法律 22 个,政治 25 个,地区行政 17 个。作者为这些平台实现 MCP server,把官方文档解析成带类型签名和自然语言描述的函数接口,总计 2,318 个 live endpoint-backed functions。
这不是一个“让模型从十个玩具函数里选一个”的测试。平均每个评测任务需要 3.32 个顺序步骤、4.92 次工具调用;59% 的任务含有并行调用;平均暴露给智能体的可用工具数是 7.5。主文还概括说,一个任务平均约 5 次工具调用,最多 14 次。
作者没有只让模型最后答对就算完,也没有只看工具调用是否长得像金标准。评估被拆成三条线:RESPONSE 看最终答案,ENVIRONMENT 看服务器状态,ACTION 看执行轨迹。ACTION 总是被包含,但论文明确提醒:只看 ACTION 不够。因为模型可能调用过正确工具,却留下错误状态;也可能通过另一条合理路径达到正确结果。
任务标注也经过两轮核验。一个非任务作者的专家先审每个任务的工具选择、参数和响应;然后执行黄金轨迹,把工具输出交给 Claude Sonnet 4.6,再和标注目标比较。初次审计发现 7 个任务有错,占 4.8%;排除模型自身失败后,80% 的任务第一次通过执行检查。所有被两阶段发现的问题都被修正并重复检查,直到 145 个任务全部通过。
这一步的意义在于,它把“工具调用能力”从静态格式题,拉回了一个更现实的问题:模型能不能在一个会返回很多记录、会要求代码转换、会因为 live endpoint 漂移而出错的环境里,把过程走完整。
为什么现有数据不够:多记录交接才是隐藏难点
我们可能会想,既然已有 ToolBench、BFCL、ToolACE、APIGen-MT 这些工具调用数据,为什么还要造一个韩国公共 API 基准?
论文给出的关键数字很有说服力。作者比较了多步轨迹中“一对多交接”的比例,以及交接字段的基数分布。ToolBench-v1 的 one-to-many chaining 只有 1.9%,APIGen-MT 是 10.0%,Nemotron 是 1.6%,ToolACE 是 4.5%。KOPA-Bench 对应的数据是 81.2%。
更夸张的是返回记录数。其他数据集在这类交接上的中位数大多是 1,p90 最高也只有 16;KOPA-Bench 的中位数是 27,p90 是 157,最大值达到 224,958。
这说明问题不是“韩国 API 比较特别”这么简单。公共数据服务天然会把世界摊开给你:所有公告、所有候选、所有区域记录、所有公司披露。工具调用智能体如果只能处理单值链路,就像一个人只能读表格第一行。它确实“看到了数据”,但没有真正完成任务。
EDGE:先建图,再让现实把图修干净
EDGE 的第一阶段把 2,318 个工具看成图里的节点。边表示一种可能的依赖:上游工具某个输出字段,可以绑定到下游工具某个输入参数。
但这里有一个规模问题。全量比较所有工具对是平方级,太贵。作者先用签名 embedding 的 dense retriever 给每个源工具选候选邻居:同领域 top-15,跨领域 top-10。然后让 LLM 为每条候选边给出可行性分数、字段绑定关系,以及未绑定参数的默认候选。
到这里为止,流程仍然像很多合成数据管线:模型根据描述判断“这条工具链应该能走”。EDGE 的分水岭在下一步。
每条被接纳的边会得到一个以 LLM 分数为先验的 Beta 分布。系统不断采样路径,在真实 API 上执行。成功会增加这条边的成功证据,结构性失败会显著增加失败证据;如果只是环境性错误,比如服务端临时异常,就不会被当成同等严重的结构失败。路径选择用 Thompson sampling,同时加一个 ε-greedy 的探索底线,避免冷启动边永远得不到尝试。
当某条边的后验概率显示它“成功率超过剪枝阈值”的可能性太低,并且试验次数达到最低要求,它就会被剪掉。迭代到收敛后,剩下的图记为 G*。
这个设计的聪明之处在于,它没有把 LLM 当成真理,也没有把 live API 的偶发故障当成绝对否定。LLM 提供候选,真实执行提供证据,贝叶斯后验负责把“看起来可行”和“真的跑通”分开。
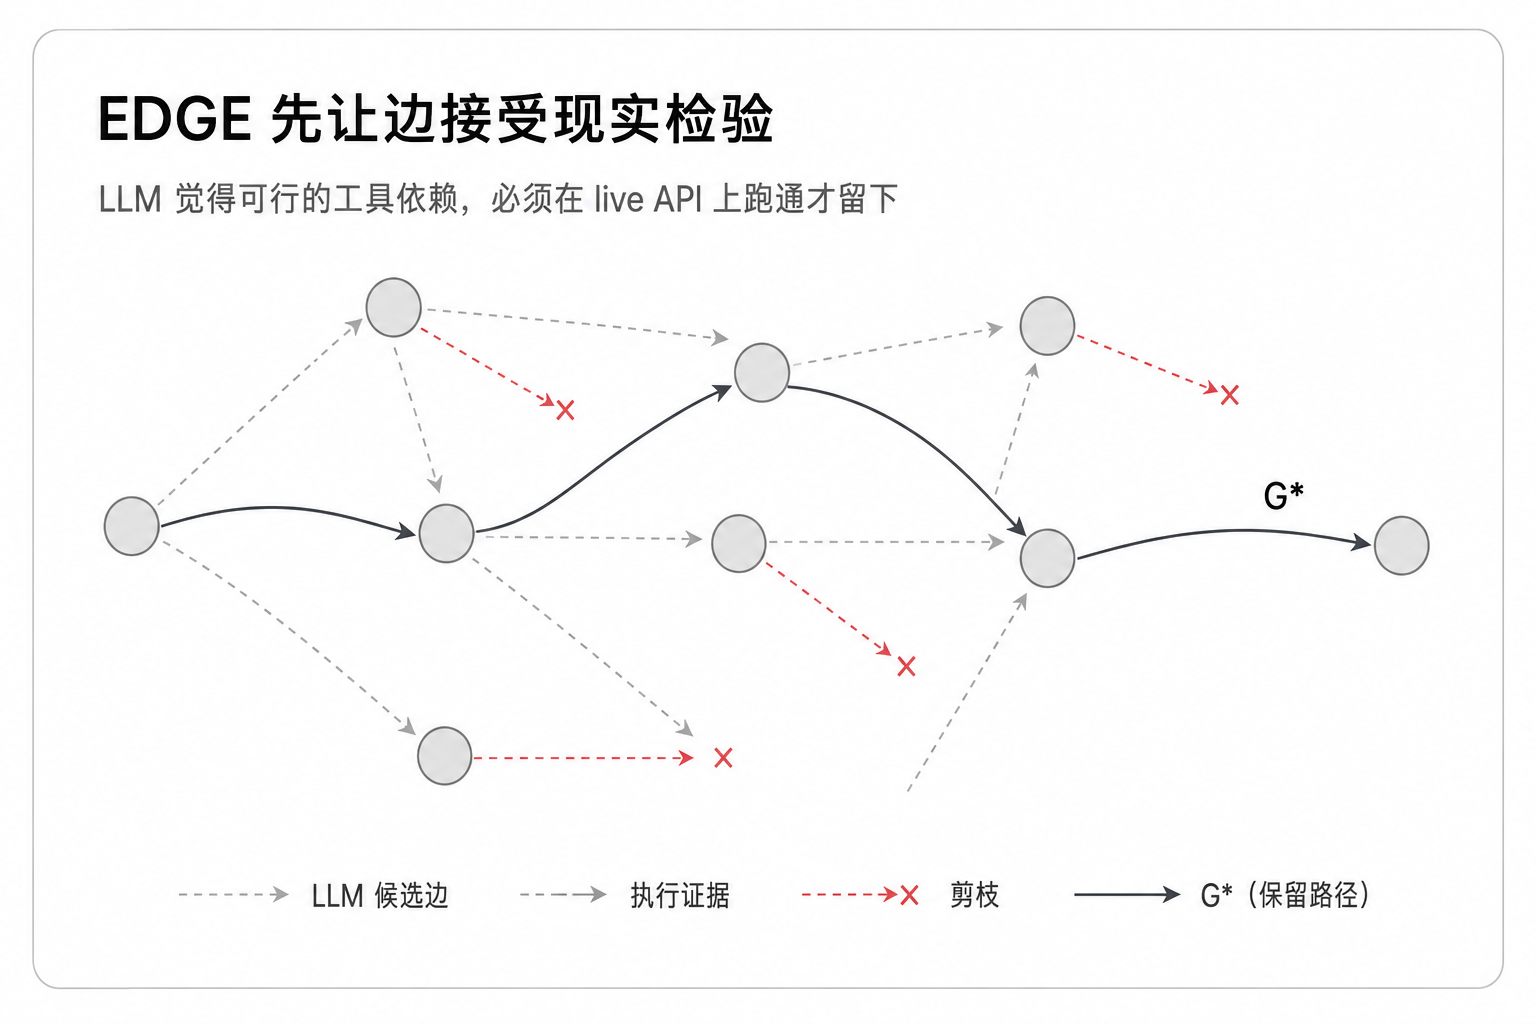
实验里,这个分离很清楚。未经执行细化的 skeleton edges,实际执行成功率只有 50.2%。收敛后的 G* 达到 62.7%,提升 12.5 个百分点。被剪掉的边只在 14.8% 的情况下能执行。更进一步,70.5% 的 pruned edges 在任何试验中从未成功过;而 G* 中这样的零成功边比例是 27.7%,且作者解释它们主要集中在试验次数很少的边上,反映的是探索不足,而不是已证明失败。
附录还给出动态过程:100 次 Phase A 迭代中,trajectory pass rate 提升 31 个百分点,step success rate 提升 28 个百分点。这说明剪枝不是随机删除,而是在把执行流量逐步集中到可运行依赖上。
有了干净的图,还要把轨迹写成模型能学的数据
第二阶段不是简单地在 G* 上随机游走。因为一条边即使可执行,交接处也可能返回很多值。
EDGE 给每个 junction 按返回值基数分型。若只有一个值,就是 Seq,直接传给下游。若有 2 到 5 个值,在 fan-out budget φ=5 内逐个调用下游,这叫 Fan。若超过 5 个,就插入一个内部处理节点,先做确定性缩减,这叫 Drv:数值字段可以取最大、最小、≥、≤;枚举字段做 equality;日期字段做 date-after;通用情况下可以用 most-frequent。阈值类和相等过滤的 pivot 从观测字段值里选,保证过滤后最多留下 φ 个不同值。
除顺序轨迹外,EDGE 还合成三种非顺序结构:Semantic-parallel 用共享参数调用独立工具并合并结果;Comparison 用不同参数调用同一工具并比较;Conditional 根据中间结果选择分支。最后,LLM 根据这些结构生成韩文自然语言查询,并从缓存的执行结果推导答案,再经过三阶段过滤:规则过滤、LLM 静态过滤、独立重解。
过滤这一步不是洁癖。live API 会变,LLM 会生成格式坏掉、答案泄漏、不可评分、装饰性链条等异常。论文报告,移除这些问题任务后,pass@1 从 0.242 提到 0.309,增加 6.7 个百分点。
最终训练集有 1,781 条任务。平均每个任务 4.13 次调用,中位数 4 次,最多 36 次;42.3% 的任务不超过 3 步,50.9% 是 4 到 5 步,6.7% 至少 6 步;调用层面 63.8% 是顺序,36.2% 是并行。类型分布里 Mixed 最大,占 36.7%;Drv 占 19.7%;Sem 占 17.0%;Seq 占 12.1%;Cmp 占 9.0%;Cond 和 Fan 分别占 2.8% 与 2.7%。
结果:4B、9B 小模型真的学到了什么
作者用这 1,781 条 EDGE 数据训练 Qwen3.5-4B 和 Qwen3.5-9B,训练目标是 GRPO,奖励是 RESPONSE 和 ENVIRONMENT 维度上的二值成功信号。训练在 8 张 H100 上用 verl 完成。评测时每个任务采样 4 个独立 rollout,报告 pass@1 和 pass@4;另外用 8 个随机种子估计 pass@1 的 95% 置信区间。
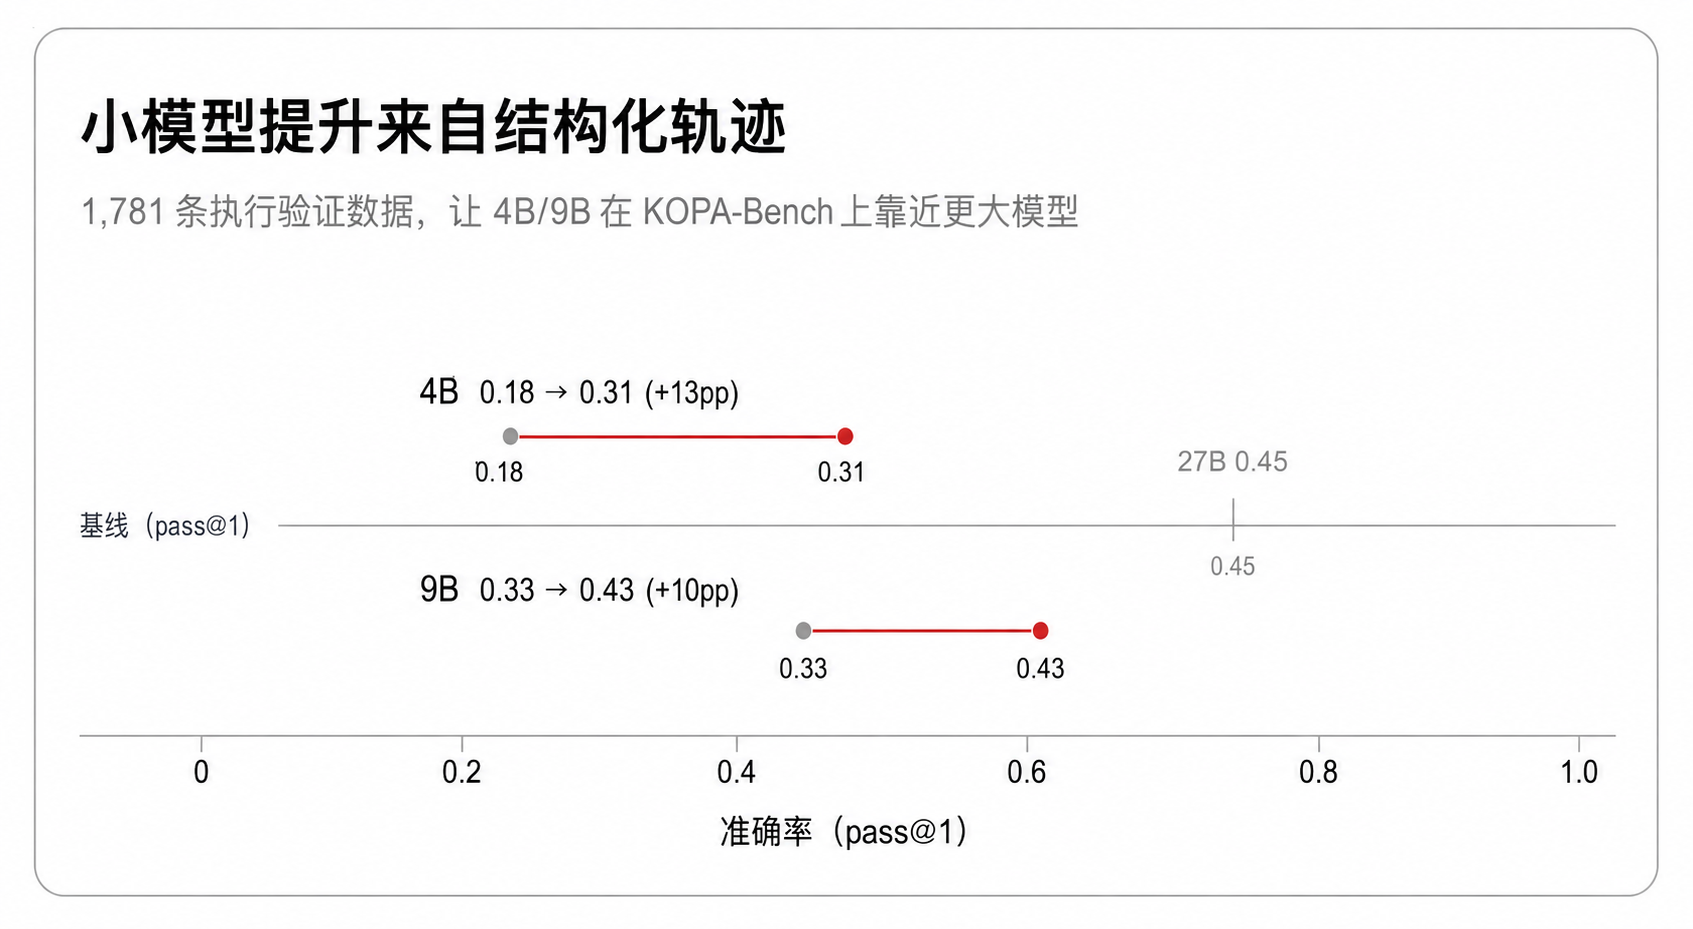
主结果很直接。Qwen3.5-4B 的 KOPA-Bench pass@1 从 0.1758 到 0.3094,约 +13 个百分点;pass@4 从 0.3103 到 0.4690;Action 从 0.2140 到 0.3462。Qwen3.5-9B 的 pass@1 从 0.3275 到 0.4310,约 +10 个百分点;pass@4 从 0.4690 到 0.5517。
这让 9B 微调模型接近同系列未微调 27B 的 pass@1 0.4482。论文摘要里说“9B nearly matches untuned 27B”,主表数字支持这个说法,但也要注意它不是超过 27B,而是接近。
更有意思的是 BFCL。训练分布是韩国公共 API,但两个微调模型在 BFCL 上总体没有掉,反而相对 base 有提升;multi-turn 改善最大:4B +4.04pp,9B +5.87pp。论文的解释是,多步工具轨迹和多轮对话结构有相似性,因此结构迁移到了分布外任务上。这个解释合理,但仍应把它看成实验现象加作者推断,而不是已完全拆解的因果机制。
消融实验也把“到底是数据有用,还是 GRPO 有用”拆开了。对同一个 1,781 任务集合,SFT 已经把 4B 的 pass@1 从 0.1758 提到 0.2724,Action 从 0.2140 提到 0.3048;GRPO 进一步到 0.3094、0.3462。也就是说,大部分提升来自 EDGE 语料本身,GRPO 再从多 rollout 的相对奖励里多挖出一些信号,特别是 pass@4 从 SFT 的 0.3586 到 GRPO 的 0.4690,提升 11 个百分点。
轨迹结构的消融则说明,不能只教顺序链。只用 pure-sequential,pass@1 是 0.2327;用 parallel+Mixed,pass@1 到 0.3080;完整数据是 0.3094。pass@4 上完整数据更明显,0.4690 高于 parallel+Mixed 的 0.4000。作者也诚实指出,完整数据的 Action 低于 parallel+Mixed(0.3462 vs 0.4070),但解释为完整数据额外解决了一些更长程任务,效率加权的 Action 会更吃亏。
这篇论文真正证明了什么
它证明的第一件事,是 KOPA-Bench 里的真实公共 API 多步任务确实比许多现有工具调用数据更强调一对多交接。81.2% 的 one-to-many chaining、224,958 的最大交接基数,是这篇论文最有辨识度的数字之一。
第二,它证明执行接地的动态图比只靠 LLM 判断依赖更可靠。Skeleton 50.2%、G* 62.7%、pruned 14.8%,再加上 100 轮迭代中 pass rate 的提升,构成了较完整的证据链。
第三,它证明这类合成轨迹可以明显改善小开源模型在 KOPA-Bench 上的表现,并且 8 seed 置信区间支持这种提升不是小样本偶然。附录报告 4B base 的八种子 pass@1 区间是 [0.1400, 0.1807],4B ours 是 [0.2762, 0.3100];9B base 是 [0.3277, 0.3775],9B ours 是 [0.4040, 0.4235],两组都不重叠。
第四,它做了较认真污染审计。145 个评测 query 中没有一个和训练 query 完全重复。工具 universe overlap 是 62.2%(135/217 gold functions),这是同一公共 API 池下预期会有的共享,而不等于任务泄漏。更严格看 dependency edge,评测里的 178 个 dependency-edge occurrences 在训练中 100% 未见,Jaccard 为 0.000;即使用更宽松的 adjacency edge,95.6% 的 occurrences 仍是 unseen。held-out platform 上,4B 的 pass@4 从 0.2903 到 0.5161,31 个任务里从 9 个解到 16 个,也支持提升不只是背熟平台。
还没有证明什么
边界同样重要。
第一,KOPA-Bench 是韩国公共部门 API。它刻意隔离了多步、高基数、韩文公共服务场景,但还没有证明结果能无损迁移到其他语言、其他国家行政系统、商业私有 API,或内部企业工具链。
第二,live endpoint 是优点,也是可复现风险。论文承认 schema、可用性、返回记录都会随时间漂移。作者过滤了实时数据任务,并用环境状态 hash 做评估,但精确复现仍依赖他们无法控制的公共服务稳定性。
第三,EDGE 的训练效果是在 Qwen3.5-4B/9B 上展示的。它接近同系列 27B,但没有说明对所有小模型、所有训练目标、所有工具调用框架都会同幅度有效。
第四,执行接地能筛掉很多坏边,但不是让图完美。G* 中仍有零成功边,作者解释为 under-exploration;这提醒我们,动态探索预算、剪枝阈值和 live API 波动会共同决定最终图的质量。
为什么这件事值得看
这篇论文的价值不在于发明了一个更炫的 agent 外壳,而在于它把工具调用从“函数签名匹配”推进到“真实服务里的数据流工程”。
很多 agent demo 失败,不是因为模型完全不会想,而是因为世界给它的中间结果不干净:代码体系不一致、返回值太多、第一页不够、状态会变、错误类型混杂。EDGE 的思路是把这些麻烦提前暴露在数据合成阶段,让模型训练时就见过“先查代码、再翻页、再缩减、再并行比较、再回答”的结构。
如果未来公共机构、企业内网和本地部署模型真的要大规模使用 agent,这类工作会变得很实际。模型不能只学会把 JSON 写对,它还要学会尊重数据接口之间的依赖关系,知道什么时候一个返回值太宽,知道什么时候必须继续查,知道什么时候看似合理的链路需要被现实执行否决。
KOPA-Bench 和 EDGE 给出的不是最终答案,但它把问题定义得更像真实世界:工具调用不是一句函数名,而是一条会在 live API 上接受检验的数据链。