ExecCritic:为什么会写测试的 Coding Agent,反而可能更容易骗过自己
一个 coding agent 修好了一个 bug,然后顺手写了一个测试。测试跑过了,终端一片绿色。
直觉上,这应该是好消息。我们一直说,agent 不能只“看起来写了代码”,它要运行测试;不能只靠语言判断,它要拿执行结果当证据。于是绿色测试像一个安全阀:只要能通过,说明补丁至少有了某种现实约束。
问题是,这个安全阀有时也会变成幻觉放大器。
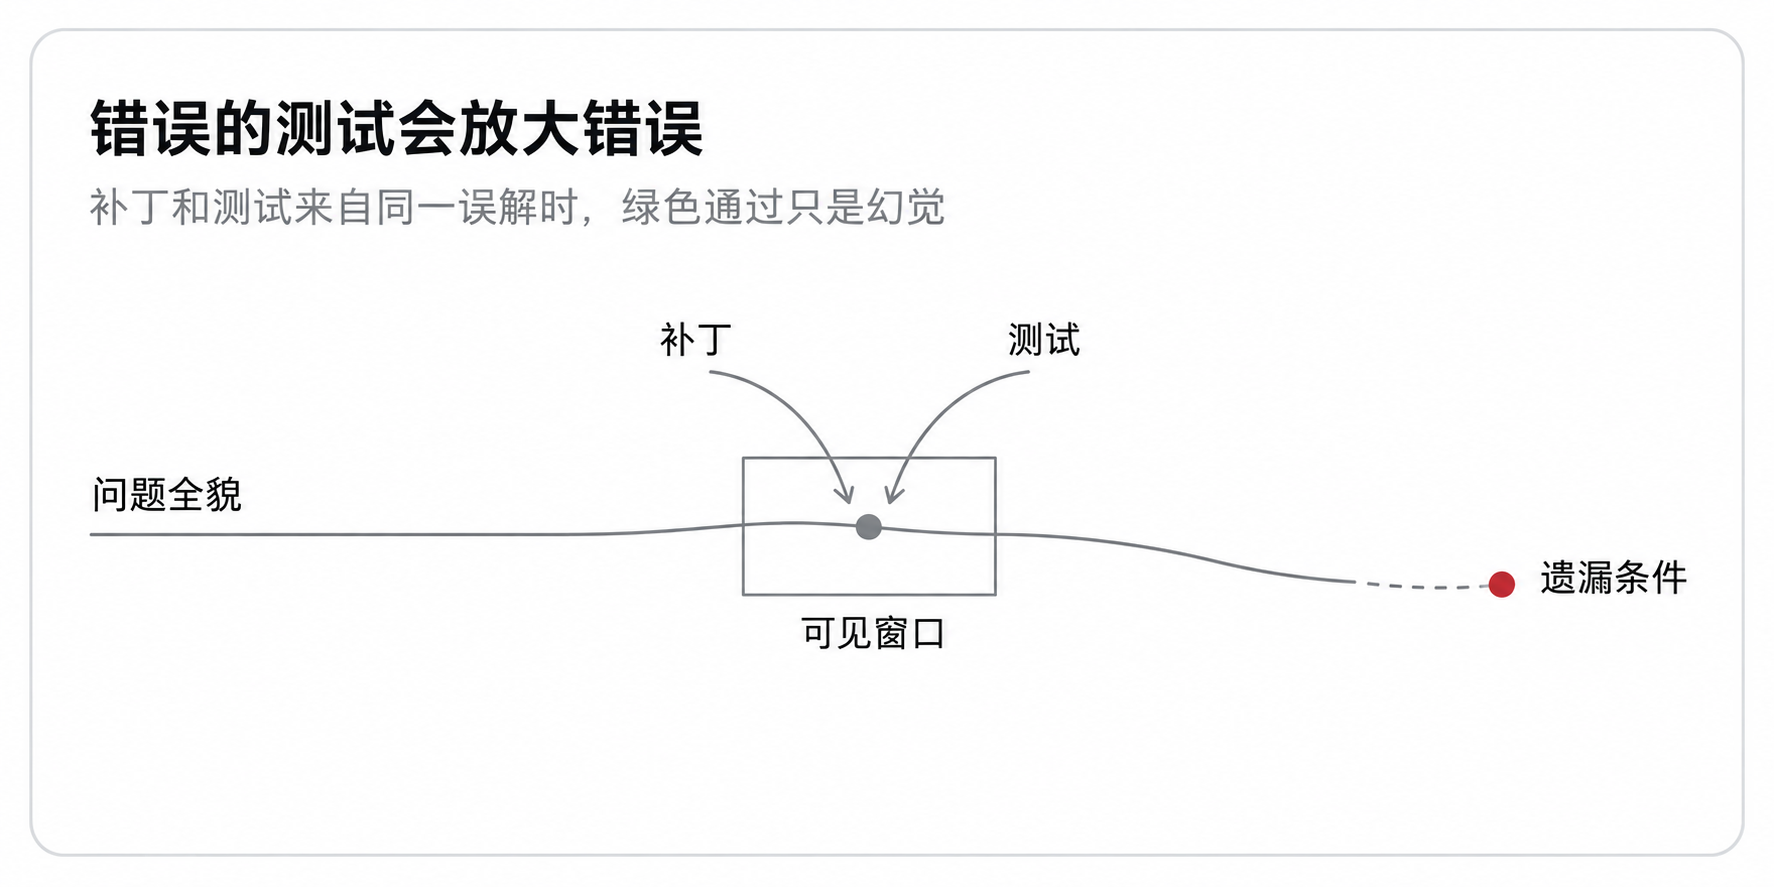
如果 agent 从一开始就误解了 issue,它写出来的补丁会解决那个被它误解的问题;它写出来的测试,也很可能检查同一个被误解的问题。补丁和测试互相点头,执行结果也确实是绿色。但它们同意的不是用户真正要修的 bug,而是同一个错误版本的任务。
这篇论文研究的,就是这个危险缝隙:执行反馈不是天然可靠。测试必须先问对问题,执行结果才有意义。
作者提出 ExecCritic,把 coding agent 的“写测试”和“改代码”拆成两个角色:一个 Test agent 负责构造能揭示 bug 的仓库原生测试;一个 Repair agent 只能在冻结的测试反馈下改源代码。中间还有一个 fail-closed harness:测试束要有 test diff、执行命令和行为契约;它必须在 buggy repository 上 clean fail,之后再用 Gold repository 做离线审计,确认它不是随便失败,而是真的对准了参考修复后的行为。
先把几个概念走一遍
我们先从一个很小的例子开始。一个函数在输入空列表时会崩,但正常列表能跑。agent 读到 issue 后,误以为问题是“普通列表的排序不稳定”。它改了排序逻辑,又写了一个普通列表测试。测试通过了。
这里的关键不在“测试是否执行”,而在“测试是否覆盖了 issue 真正要求的行为”。论文把这种由 agent 生成、会影响 agent 停止或继续修复的检查,放在一个更严格的位置上看:它不是装饰性的验证,而是 self-generated stopping evidence——agent 用来告诉自己“可以交卷了”的证据。
再往前一步。一个测试在 buggy 版本上失败,听起来已经很强。可是失败有很多原因:命令写错、依赖缺失、断言目标错、测试触发了无关异常。于是 ExecCritic 加了一个更硬的判断:同一个测试要在 Base 上 clean fail,还要在 Gold 上通过。Base 是带 bug 的仓库;Gold 是应用参考修复后的仓库。只有同时满足这两件事,测试才更像是在问“这个 bug 修没修”,而不是在问一个无关问题。
最后是“冻结”。Repair agent 得到测试反馈后,可以改源代码,但不能改测试。这个限制看起来很小,实际上很重要。否则 agent 最容易做的不是修 bug,而是把测试改到通过。冻结测试把证据和行动分开:测试定义目标,修复只能响应目标。
为什么“会跑测试”不等于“会修复”
我们可能会想,既然测试能提供执行反馈,那只要把测试生成能力接到 coding agent 上,性能自然会涨。
论文最有价值的地方,是它直接给了一个反例。
在 SWE-bench Verified 上,作者固定同一个 Qwen-3.5-35B-A3B Repair agent,只替换反馈来源。如果完全没有测试,Round-0 resolved rate 是 61.2%。如果接上 Base-35B 生成的测试,结果不是上升,而是下降到 57.3%,少了 3.9 个百分点。
这说明低质量测试不是中性信息。它会把 agent 往错误方向拉。
同一个 Repair agent,如果用 GPT-5.6-sol 生成的测试,resolved rate 提升到 65.3%,比无测试高 4.1 个点;如果用 Oracle fail-to-pass 测试,达到 69.4%,高 8.2 个点。这里的变量不是“有没有执行反馈”,而是“反馈是否来自可信测试”。
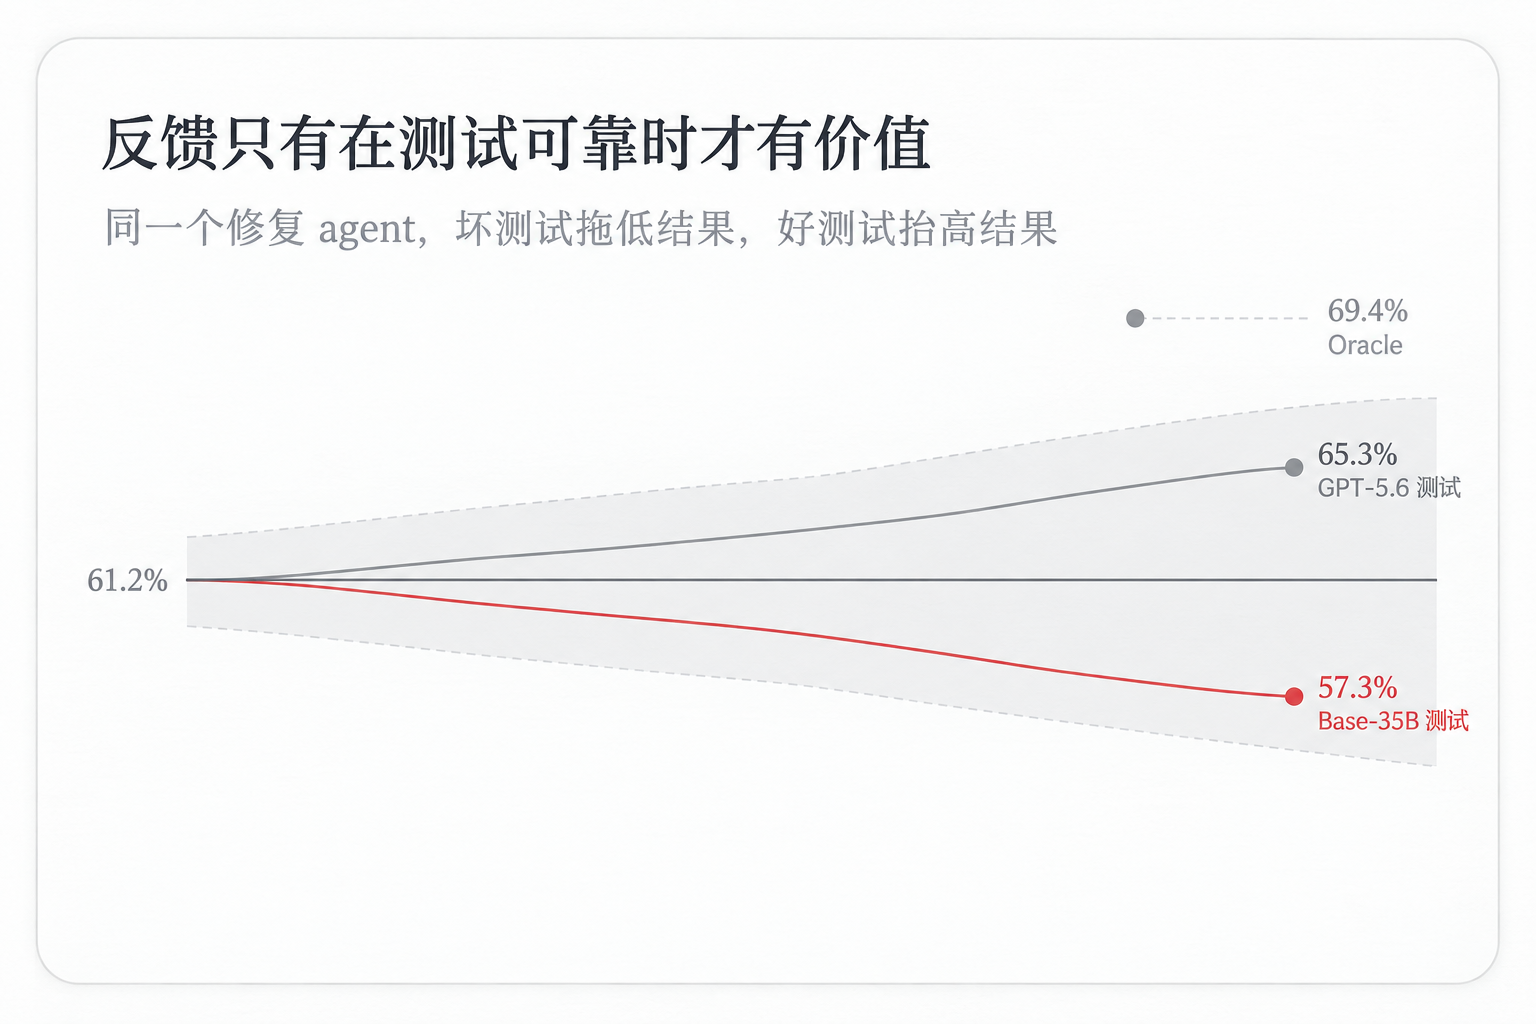
这组数字把问题重新框定了。测试不是工具调用列表里的一个附属动作,而是整个 repair loop 的目标函数。如果目标函数错了,优化越努力,错得越稳定。
ExecCritic 的第一步:让 Test agent 学会问对问题
那怎样判断一个自动生成的测试问得对不对?
ExecCritic 不让 Test agent 直接改源码。它只能提交一个 bundle:测试 diff、精确执行命令、JSON 行为契约。harness 先做格式和执行检查,然后在 Base 上运行。测试必须 clean fail,才会被保留;没有通过这个门,就不能进入后续 repair。
但 Base failure 只是第一道门。
论文的更关键定义叫 Base-to-Gold success。记号很简单:同一个测试在 Base 上失败,记作 B=1;在 Gold 上通过,记作 G=1。二者相乘,Q=B×G。只有 Q=1,才说明测试既能暴露原 bug,又不会拒绝参考修复。
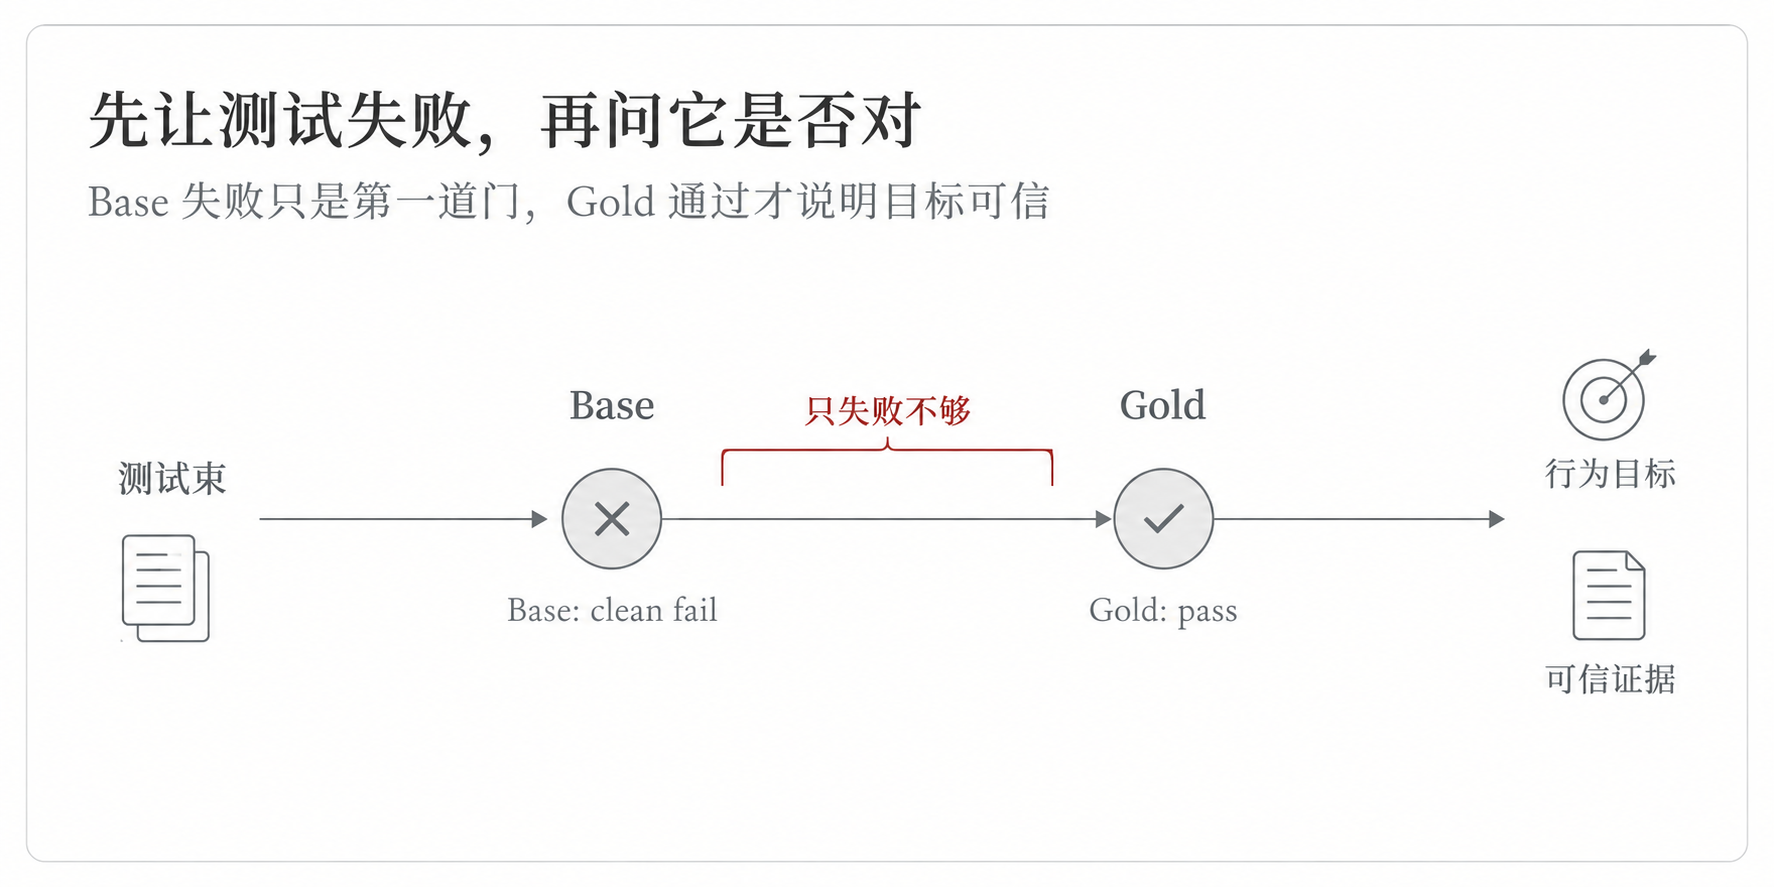
这个设计有一点很诚实:Gold 结果只用于离线训练和评估,不进入 Test agent 的生成过程,也不在部署时喂给 Repair agent。也就是说,论文没有把隐藏答案偷偷放进执行闭环。Gold 像实验室里的标尺,用来训练“什么叫好测试”;真正运行时,Test agent 仍然只能看 issue 和 Base 仓库。
结果很清楚。Qwen3.5-35B-A3B 作为 Test agent,Base-to-Gold success 只有 22.2%。经过 5,000 条 DeepSeek-V4-Flash-0731 生成的 chain-of-thought 轨迹做 SFT 后,涨到 39.6%。再经过 200 步 GRPO,涨到 62.2%。这个 62.2% 已经接近 Codex-5.3 的 61.0%,但仍低于 DeepSeek-V4-Flash 的 73.4%,更低于 GPT-5.6-sol 的 87.8%。
这里有一个有趣的层次。SFT 先教会模型仓库探索、测试构造和结构化提交协议;但把 SFT 数据从 5K 增到 10K,并没有继续提高 Base-to-Gold。真正把 39.6% 推到 62.2% 的,是 on-policy RL。原因并不神秘:模仿学习只能复制教师轨迹里出现过的行为;而 RL 会直接惩罚学生自己采样出来的坏测试,奖励它自己采样出来的好测试。
第二步:Repair agent 只允许从失败反馈里改源码
Test agent 学会提问之后,Repair agent 才进入场。
它先根据 issue 和 Base 仓库生成 Round-0 patch。然后 harness 把冻结测试应用到干净的 Base workspace 上,运行测试,返回 bounded execution feedback。Repair agent 可以继续修订,最多五轮;测试通过时立刻提交;五轮还没通过,就提交最新补丁。重要的是,测试源本身不暴露给它修改。
训练时,Repair agent 的奖励也不是“只要本地测试过了就满分”。论文把 reward 分成层级:无效补丁、改测试、终端执行无效会被处理为 0 或 zero advantage;本地失败、只本地通过、官方成功,对应不同奖励。这样做是为了避免 agent 学会“迎合测试”而不是“解决 issue”。
最终系统效果来自两个角色相加。
没有任何测试时,Base Repair agent 是 61.2%;经过 Repair training,Round-0 提升到 68.3%。当它配上 RL-35B Test agent 的反馈,Base Repair 到 64.1%,trained Repair 到 72.6%。这个 72.6% 是论文主结果:比原始无测试 baseline 高 11.4 个点,并且评估时没有使用 GPT-5.6 或 Oracle feedback。
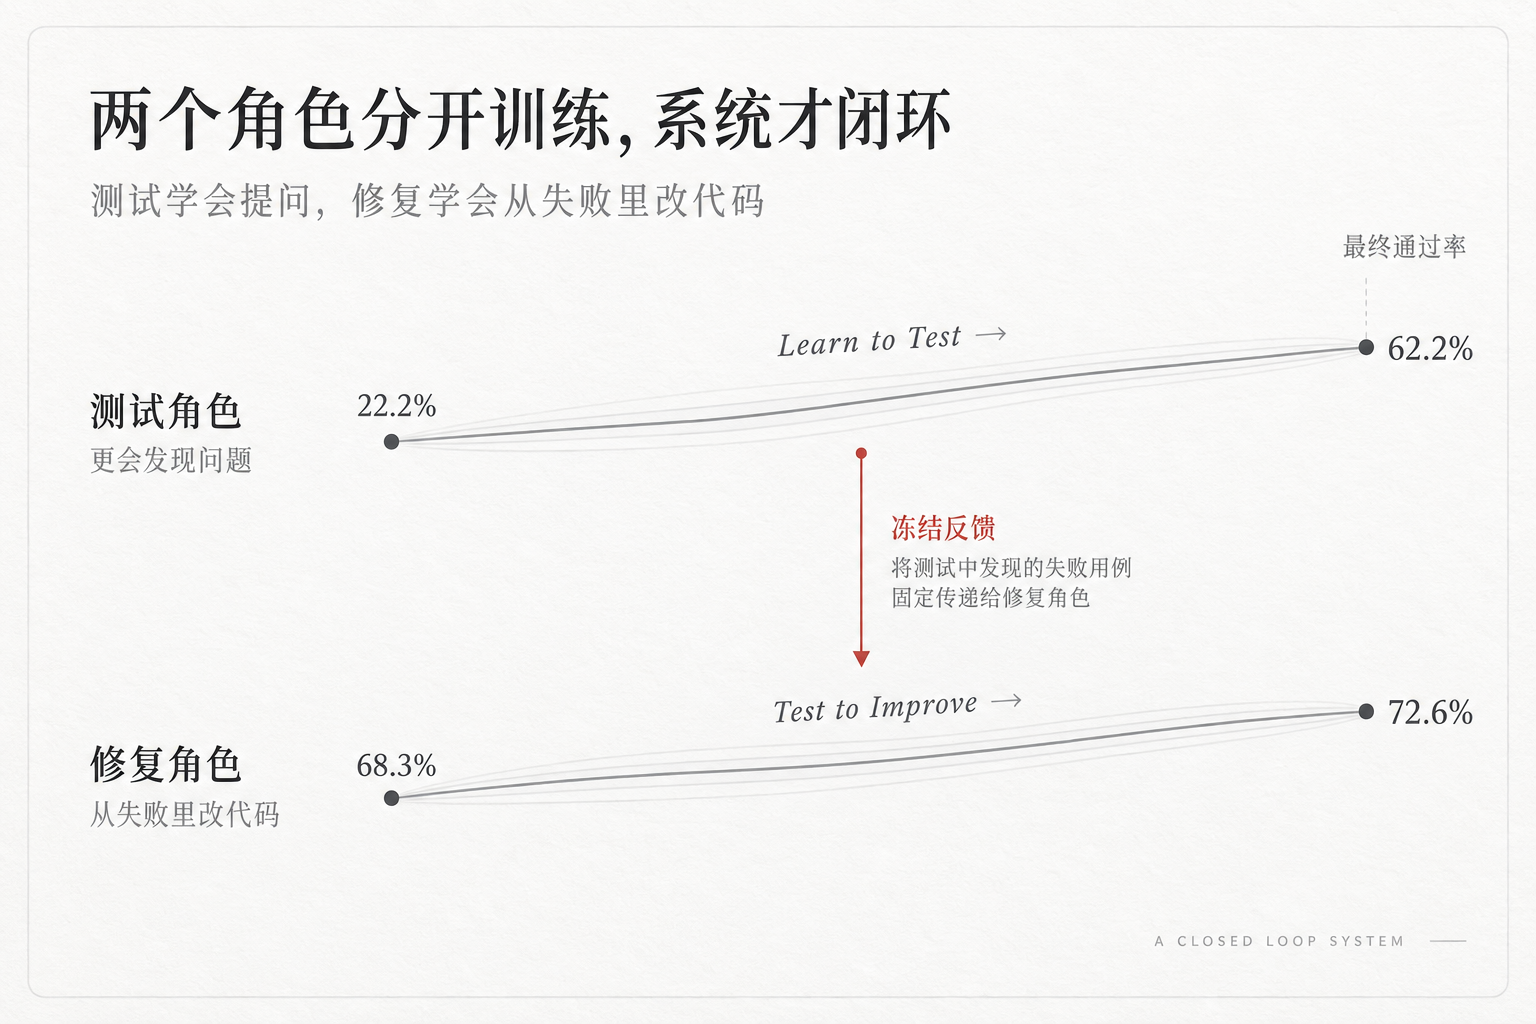
还有一个边界值得看。trained Repair agent 如果拿到 Oracle F2P feedback,可以到 77.6%。这比 72.6% 还高 5.0 个点。也就是说,ExecCritic 没有证明自动测试已经接近天花板;它证明的是,在不用更强模型和 oracle 反馈的评估设置下,训练出来的测试已经足够把系统从 61.2% 推到 72.6%。
这篇论文真正证明了什么
第一,它证明了 generated-test feedback 不是总有益。固定 Repair agent 时,Base-35B 测试会把 61.2% 拖到 57.3%;GPT-5.6 测试会推到 65.3%;Oracle 会推到 69.4%。同样叫“执行反馈”,质量不同,方向相反。
第二,它证明了 Test agent 可以被训练成更可靠的行为目标生成器。Base-to-Gold 从 22.2% 到 39.6%,再到 62.2%,说明 SFT 和 RL 分别解决了不同层面的能力:先学会流程,再在自己的分布上校正测试质量。
第三,它证明了测试角色和修复角色拆开训练是有系统收益的。最终 72.6% 不是单点 tricks,而是 Test training、Repair training、冻结反馈、fail-closed harness 共同作用的结果。
但论文没有证明三件事。
它没有证明 generated tests 可以替代官方评测。官方 evaluator 仍然是最终 correctness 的权威,本地测试只是中间反馈。
它没有证明所有 coding tasks 都会受益。主结果在 SWE-bench Verified;论文还显示在 SWE-bench Pro 上,GPT-5.6 generated tests 只带来 0.7 个点,而 Oracle feedback 能带来 11.8 个点。这说明难任务上,自动测试覆盖仍是瓶颈。
它也没有证明“更多 agent 自测”天然更安全。ExecCritic 的结论恰好相反:自测必须被独立化、冻结化、审计化,否则很容易和补丁共享同一个错误理解。
大图景:Agent 不缺动作,缺的是可信证据
过去一年,coding agent 的讨论常常围绕动作能力:会不会浏览仓库,会不会调用工具,会不会修改多文件,会不会跑测试。
ExecCritic 把焦点往后推了一步。动作本身不够,证据链才关键。测试是证据,但证据也会错;反馈能帮助修复,但反馈也能诱导错误;agent 能自我改进,但前提是它不能同时当出题人、答题人和阅卷人。
这就是这篇论文的系统意义。它不是简单说“让 agent 写测试”。它说的是:把测试变成一个可训练、可审计、可冻结的独立角色,再让修复角色在这个边界内行动。
如果未来 coding agent 真要在真实仓库里长期工作,这种边界会比单次 benchmark 分数更重要。因为真实工程里最危险的失败,不是红灯告诉你错了;而是绿灯告诉你一切都对,但那盏绿灯本身就是错的。