CUA-Universe:让电脑智能体学会在 GUI 和 CLI 之间换挡
我们平时用电脑,很少只用一种方式。
改一张图的颜色,我们可能先用鼠标在画布上确认哪个图层是目标;一旦要批量改尺寸、导出多种格式,手又会自然地伸向脚本。整理一篇论文库也是这样:人眼先在界面里确认集合、条目和附件是不是对的,真正移动几十条记录、生成引用、导出 BibTeX 时,命令或 API 会更可靠。
现在的 computer-use agent 却经常被迫像一个只会点鼠标的人。它能看截图,能点击,能拖拽,能在菜单里找按钮。问题是,这种方式很慢,也很脆。一个设置项藏在三级菜单之后,agent 可能花几十步搜索;一个本来一行命令能完成的批量修改,它可能要在界面上重复点击几十次。
反过来,纯 CLI agent 也不够。它能写脚本,能读文件,能调用工具,但如果任务依赖“屏幕上哪个对象被选中”“布局里这个节点是不是压住了另一个节点”“当前播放画面是不是正确”,纯命令行又会失明。
这篇论文要解决的,不是给 agent 再加一个工具按钮,而是更基础的问题:怎样让 agent 在同一个真实应用状态上,同时拥有 GUI 和 CLI,并学会什么时候看、什么时候写、什么时候从一个界面切到另一个界面。
这个系统叫 CUA-Universe。
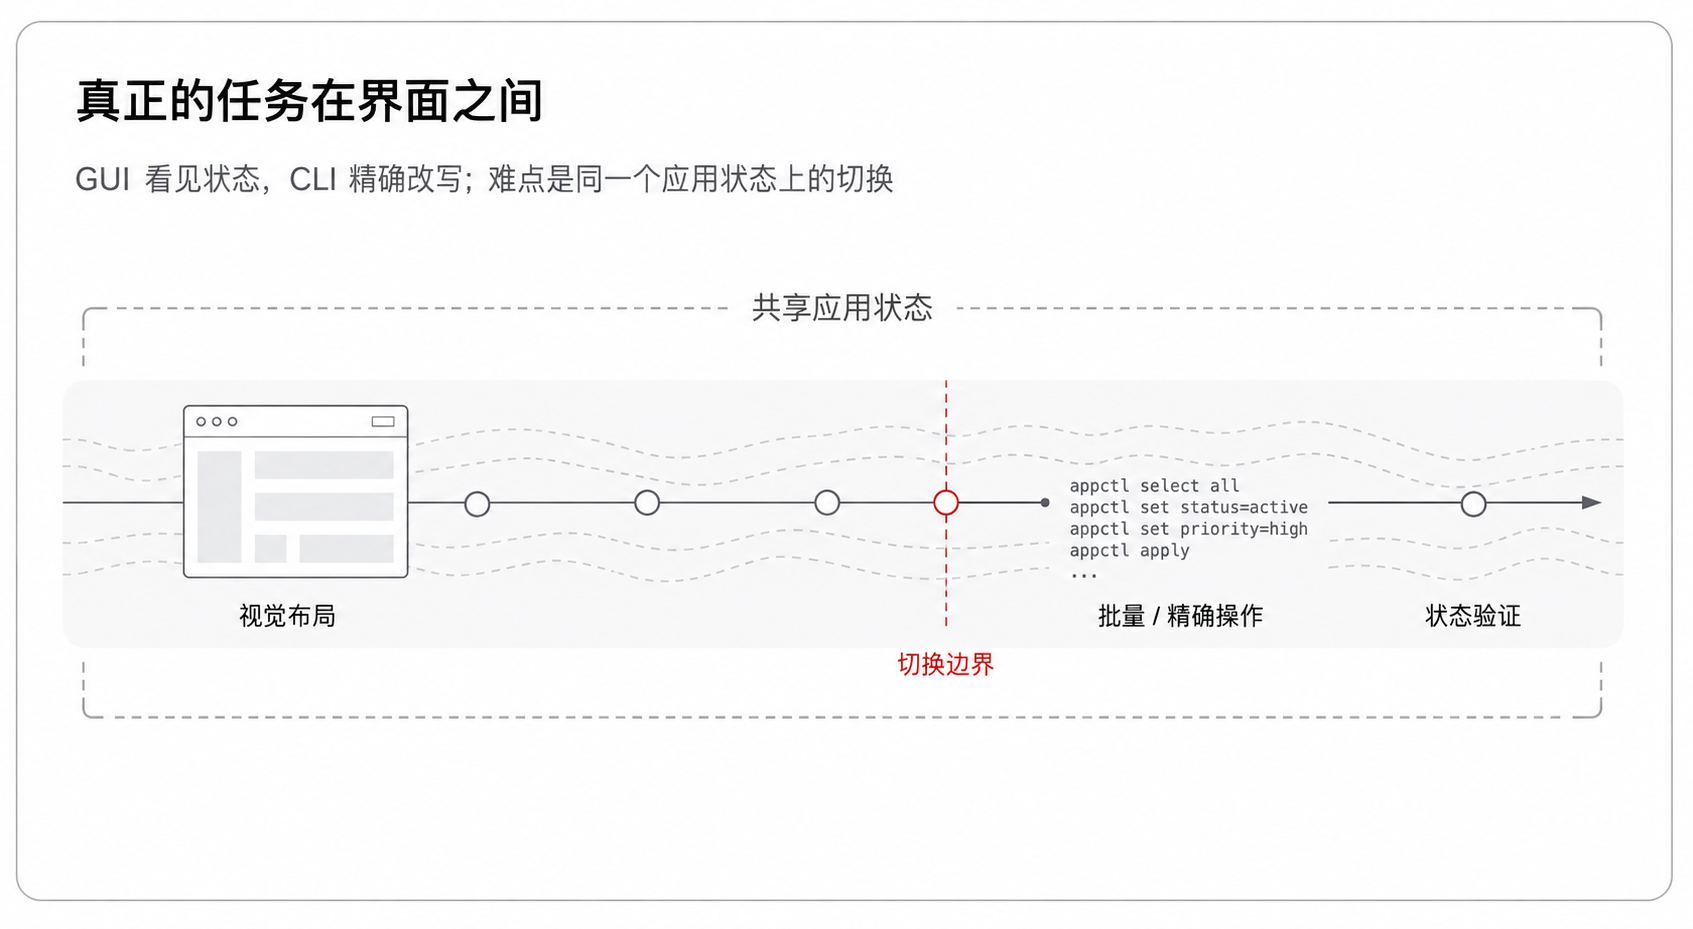
先把三个概念讲清楚
想象我们要训练一个会用 Blender、Zotero、GIMP、LibreOffice、VLC 的 agent。最笨的办法,是人工写一批任务:打开文件,点击这里,修改那里,然后保存。这样可以做一个 benchmark,但很难变成持续生产训练数据的工厂。
CUA-Universe 的第一步,是先把真实软件“装进”一个可复现的环境。每个应用都在虚拟机里能稳定启动,能打开真实 seed 文件,也能暴露一组命令行或程序化接口。Blender 可以通过 bpy 操作场景,LibreOffice 可以通过 UNO 改文档,VLC 可以通过 cvlc 或转码工具处理媒体。对没有现成接口的地方,系统再包装或生成 agent 可见的 CLI。这个把应用变成环境的过程,论文叫 App-Forge。
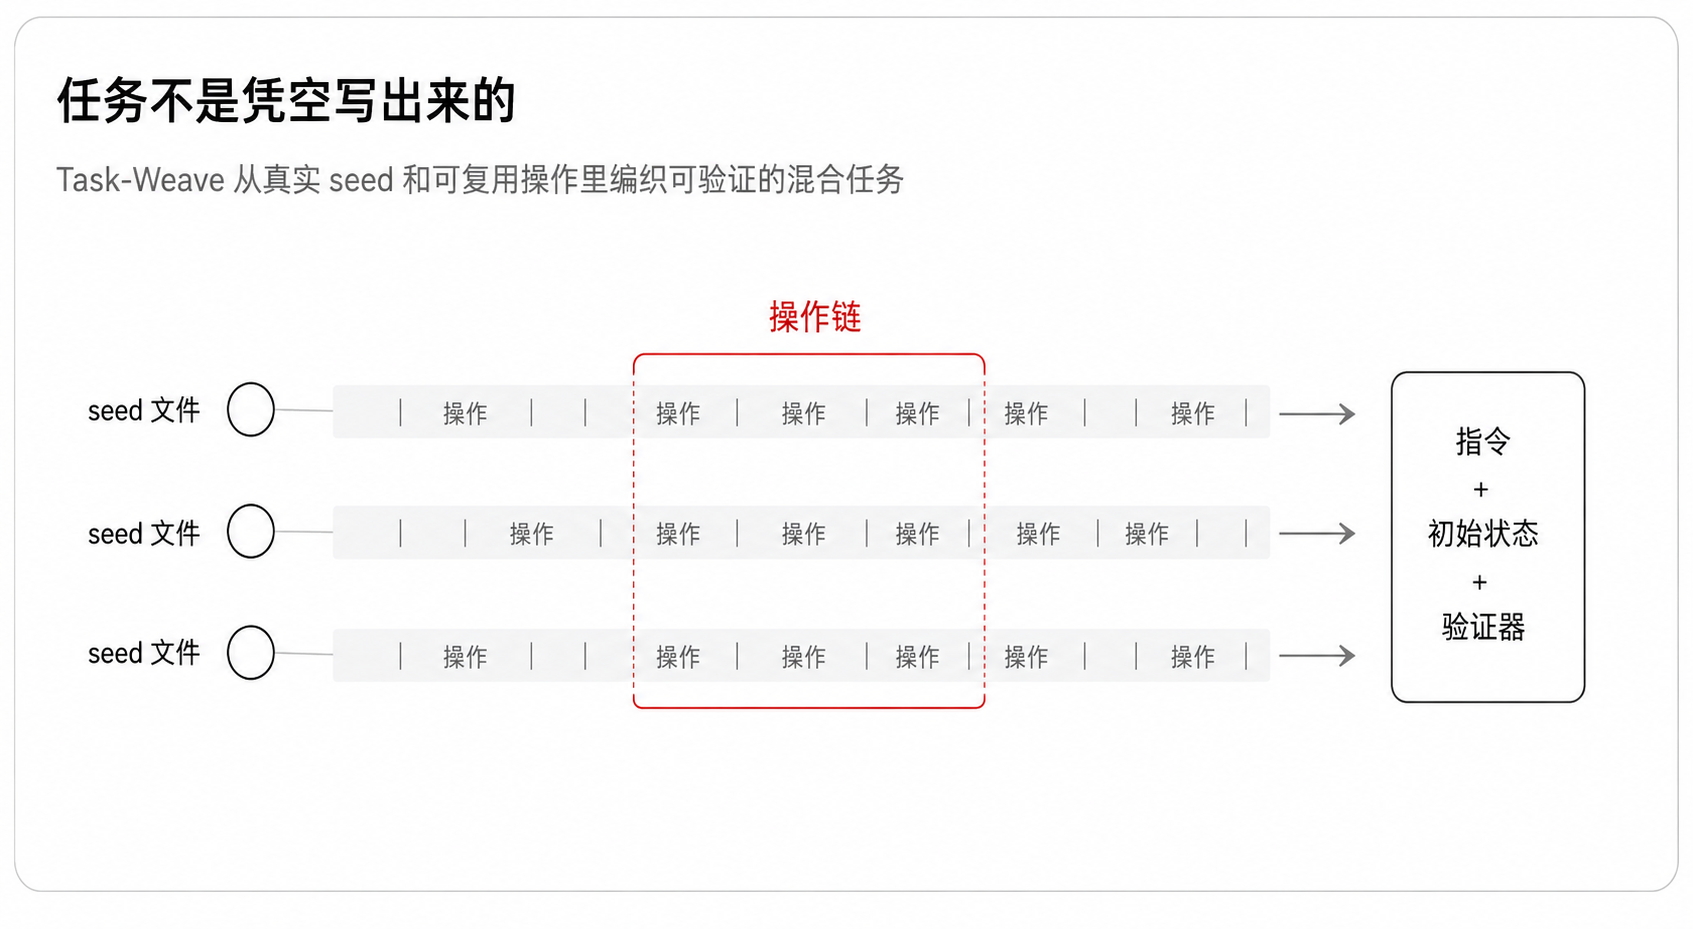
但有了环境,还没有任务。任务不能凭空编一句“请优化这个项目”,因为真实软件里必须确实存在可改的对象,任务也必须能被验证。于是系统先让探索 agent 在 seed 文件上跑,记录截图和动作,再把一段段轨迹抽象成更高层的“操作”:不是“点击第 347 个坐标”,而是“导出场景为 glTF”“给时间线片段添加滤镜”“把文献移动到某个集合”。然后把这些操作按链条组合到具体 seed 上,生成自然语言任务、初始状态和验证器。这个把真实 seed 和可复用操作编织成任务的过程,叫 Task-Weave。
最后,还要生成训练轨迹。这里最关键的不是让 agent 随便试,而是给它一个轻量的路线偏好:批量、精确、高吞吐的部分更适合 CLI;依赖视觉布局或界面状态的部分更适合 GUI。这个偏好不会告诉 agent 每一步怎么做,只是在任务层面把路径往更有效的混合执行方向推。论文把它叫 Path-Steer。
三个词合在一起,就是这篇论文的主线:先把真实应用铸造成双接口环境,再从真实状态里编织混合任务,最后把 agent 引导到更短、更可靠的 GUI+CLI 轨迹上。
为什么“加一个 CLI 工具”还不够
直觉上,我们可能会想:既然 GUI 慢,那就给所有 agent 加一个 execute_cli,让它们自己用命令行不就好了?
论文的实验恰好说明,这个直觉只对了一半。
在 OSWorld 的 244 个受控任务上,研究者比较了同一个模型在 GUI-only 和 GUI+CLI 两种接口下的表现。任务文本、环境和 verifier 保持一致;GUI+CLI 只是在原有截图和鼠标键盘动作之外,多给一个应用相关的命令行工具入口。
结果很有意思。强闭源模型当然能从 CLI 里获得一点收益,但收益并不大。GPT-5.5 从 66.8% 到 68.0%,大约多解 3 个任务;Seed2.1 Pro 从 55.7% 到 59.0%,大约多解 8 个;Kimi K2.5 基本持平,从 53.7% 到 54.5%。EvoCUA-8B 也只是从 40.6% 到 43.3%。
也就是说,接口暴露出来,不等于模型就会用好。
真正大的变化出现在 CUA-Universe 训练过的 9B 模型上。它的基座是 Qwen3.5-9B。未调优时,GUI+CLI 模式下只有 24.6% 的 OSWorld 成功率;经过 CUA-Universe 轨迹训练后,成功率达到 40.2%。如果和它自己的 GUI-only 版本比,GUI+CLI 带来 +16.8 个百分点,论文换算为新增 41 个原本失败的任务。
这说明 agent 缺的不是“工具存在”这个事实,而是“知道何时切换”的行为模式。
一个具体例子更好理解。论文附录里给了 VS Code 设置任务:目标是把 debug.focusEditorOnBreak 改成 false。GUI-only agent 在设置界面里反复搜索、点击,最后用完 60 步也没有正确落盘。GUI+CLI agent 则先用界面定位相关设置,再直接写 settings.json 并验证持久化,5 次 CLI 调用加 12 个 GUI 动作就完成任务。
GUI 在这里不是废物。它负责定位和确认。CLI 也不是万能钥匙。它负责精确、可验证的写入。真正的能力是把两者接到同一条轨迹里。
App-Forge:把 16 个真实软件变成共享状态环境
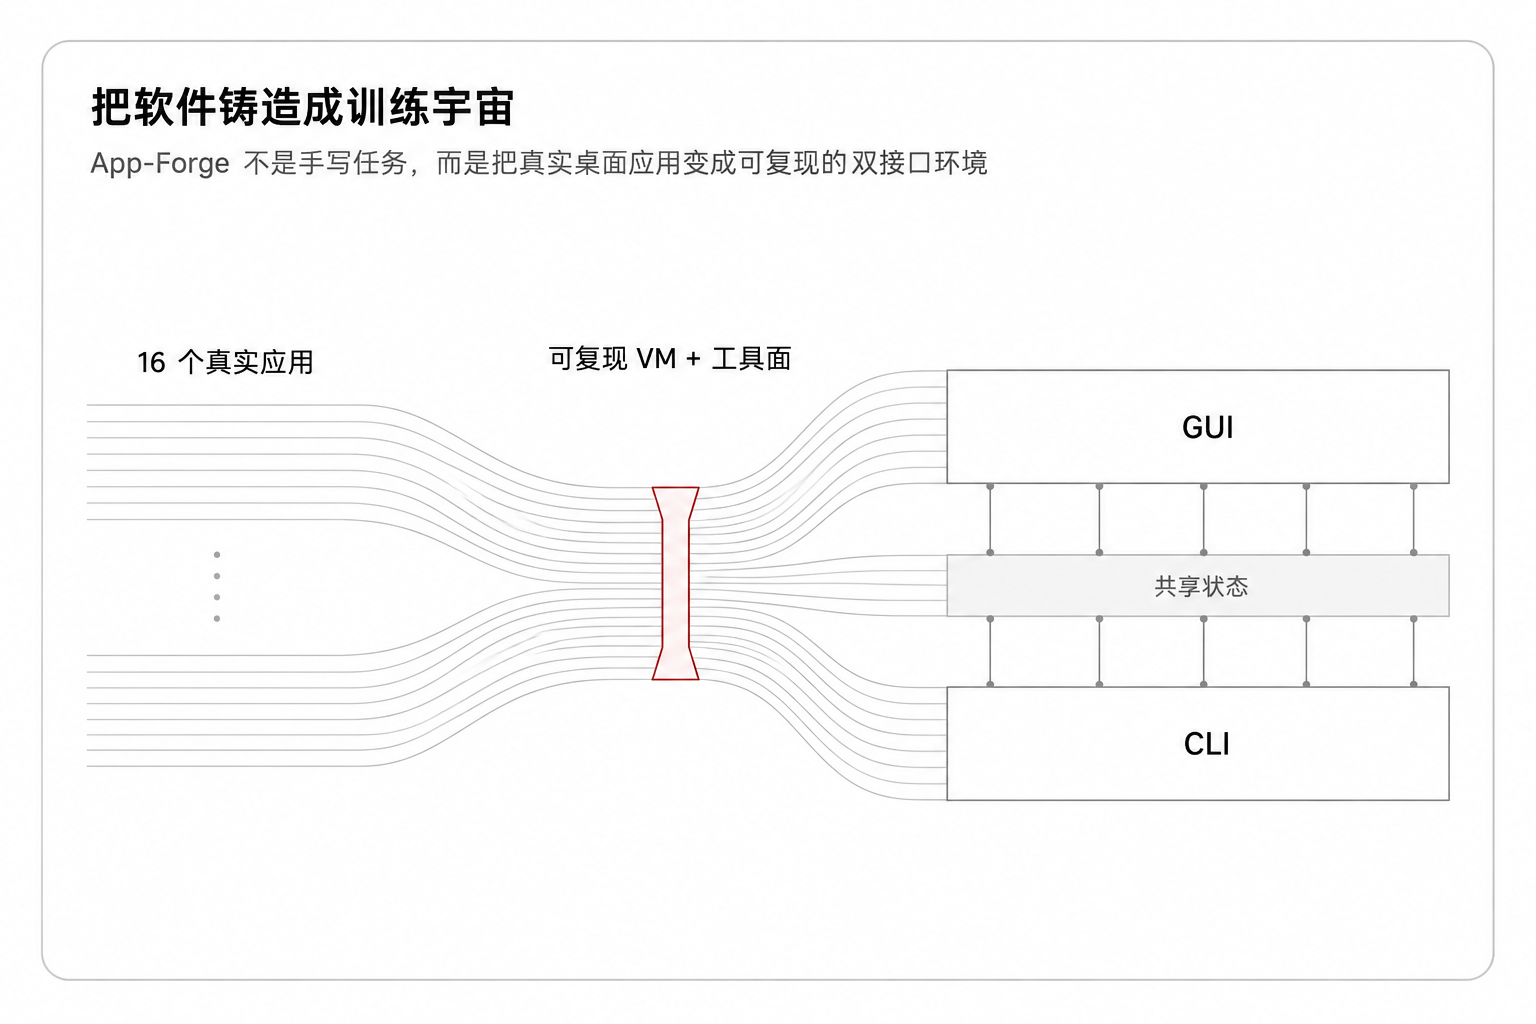
如果只在网页里训练 agent,环境构造相对容易:DOM、按钮、状态、验证逻辑都比较统一。桌面软件麻烦得多。GIMP、Blender、QGIS、Zotero、OBS、LibreOffice、VLC、Thunderbird,每个应用的安装方式、文件格式、运行依赖、脚本接口都不同。
CUA-Universe 的做法不是要求研究者为每个应用手工写完整环境,而是让一个 coding agent 参与环境适配。它在持久 VM harness 里安装和配置目标应用,调试启动失败,最后把成功配置蒸馏成可复现的环境。论文中 App-Forge 由 Codex coding agent(GPT-5.6)驱动。
工具层也不是单一路线。论文列了三种来源:第一,发现应用本来就有的命令行能力,比如 blender --python-expr 和 cvlc;第二,包装已有 scripting API,比如 Blender 的 bpy、LibreOffice UNO、GIMP Script-Fu;第三,当现有接口不够时,生成 agent-native CLI。
最后的规模是 16 个桌面应用,约 404 个 agent-visible commands。其中 8 个来自 OSWorld:Chrome、GIMP、LibreOffice Calc、LibreOffice Impress、LibreOffice Writer、Thunderbird、VLC、VS Code;另外 8 个是 CUA-Universe 扩展:Audacity、Blender、Draw.io、Godot、Kdenlive、OBS Studio、QGIS、Zotero。
这个数字本身不只是“覆盖面大”。更重要的是,每个应用都有 GUI 和 CLI,并且两者操作的是同一个底层状态。命令行改了项目文件,GUI 视图需要重新同步;GUI 里打开的 seed 文件,也要能被工具读取和修改。没有这个共享状态,所谓混合任务就会变成两个互不相干的沙盒。
论文在工具清单里也能看出这种设计取向。GIMP 有 46 个命令,覆盖 project、canvas、layer、filter、draw、export、live session;Blender 有 45 个命令,覆盖 scene、object、material、modifier、camera、animation、render;QGIS 有 38 个命令,覆盖 project、layer、feature、layout、process、export。命令不是为了凑数,而是映射每个应用真实可执行的能力面。
这一步的意义是:训练数据不再只来自人工写好的任务,而来自一个能持续打开真实软件、改真实文件、验证真实状态的环境工厂。
Task-Weave:任务必须从真实状态里长出来
很多 agent benchmark 的隐藏风险,是任务语言听起来合理,但环境里未必真的有对应对象。比如“把右上角的红色节点连接到输出端口”,如果图里根本没有这个节点,agent 失败就不是能力问题,而是任务本身幻觉。
Task-Weave 的设计,就是尽量把任务生成绑在证据上。
它先准备 seed:真实的 .blend 场景、.odp 幻灯片、.drawio 图、.aup3 音频工程、Zotero library、QGIS 项目等。seed 不是一句 prompt,而是一个已经能在原生 GUI 里打开的应用状态。附录里说,这些 seed 由 coding agent 从公开仓库和资产库搜索下载,再用格式转换工具规范化。
接着,探索 agent 会在这些 seed 上尝试不同目标,比如结构与可见性、外观、导出与组织。系统在轨迹上滑动窗口,用 LLM 把局部交互抽象成高层操作。然后过滤掉太琐碎、不可复用的候选,做去重、聚类和聚合,形成 operation pool。
有了 operation pool,系统才开始合成任务。它会根据具体 seed 的元数据和对象,采样操作链,判断这条链对当前 seed 是否有意义,控制难度从单操作到多步混合工作流。最后由一个 ReAct-style review agent 启动真实应用,短程执行检查任务是否可行、是否歧义、是否已经被初始状态满足;能修的就改写,不能修的丢弃。
这和“让 LLM 批量写任务”有本质区别。LLM 仍然参与生成,但每一步都被 seed、工具、执行反馈和 verifier 约束住。任务不是从语言里飘出来的,而是从真实状态和可执行操作里长出来的。
论文用这个流程构造了 CUA-Verse:8 个 CUA-Universe 扩展应用,每个 20 个任务,总共 160 个 held-out hybrid tasks。附录进一步说明,这些任务平均需要 5.7 个抽象工具,其中 59% 是 CLI,而且每个应用都混合 GUI 与 CLI。Blender 更偏 GUI,因为空间 3D 操作依赖视觉;Zotero 和 Kdenlive 更偏 CLI,因为结构化库管理和时间线编辑适合命令化。
这也是 CUA-Verse 和普通 GUI benchmark 的区别:它不是测试“会不会点”,而是测试“能不能在同一状态上协调两种操作面”。
Path-Steer:同样的工具,为什么路径会变短
现在我们有环境,有任务,还要收集训练轨迹。
最直接的方法是让强模型自由 rollout,成功的留下,失败的丢掉。但在混合环境里,自由探索很容易走歪:该用命令的时候在 GUI 里慢慢点;该看界面的时候写一段脆弱脚本猜状态;遇到失败后在同一种界面里反复撞墙。
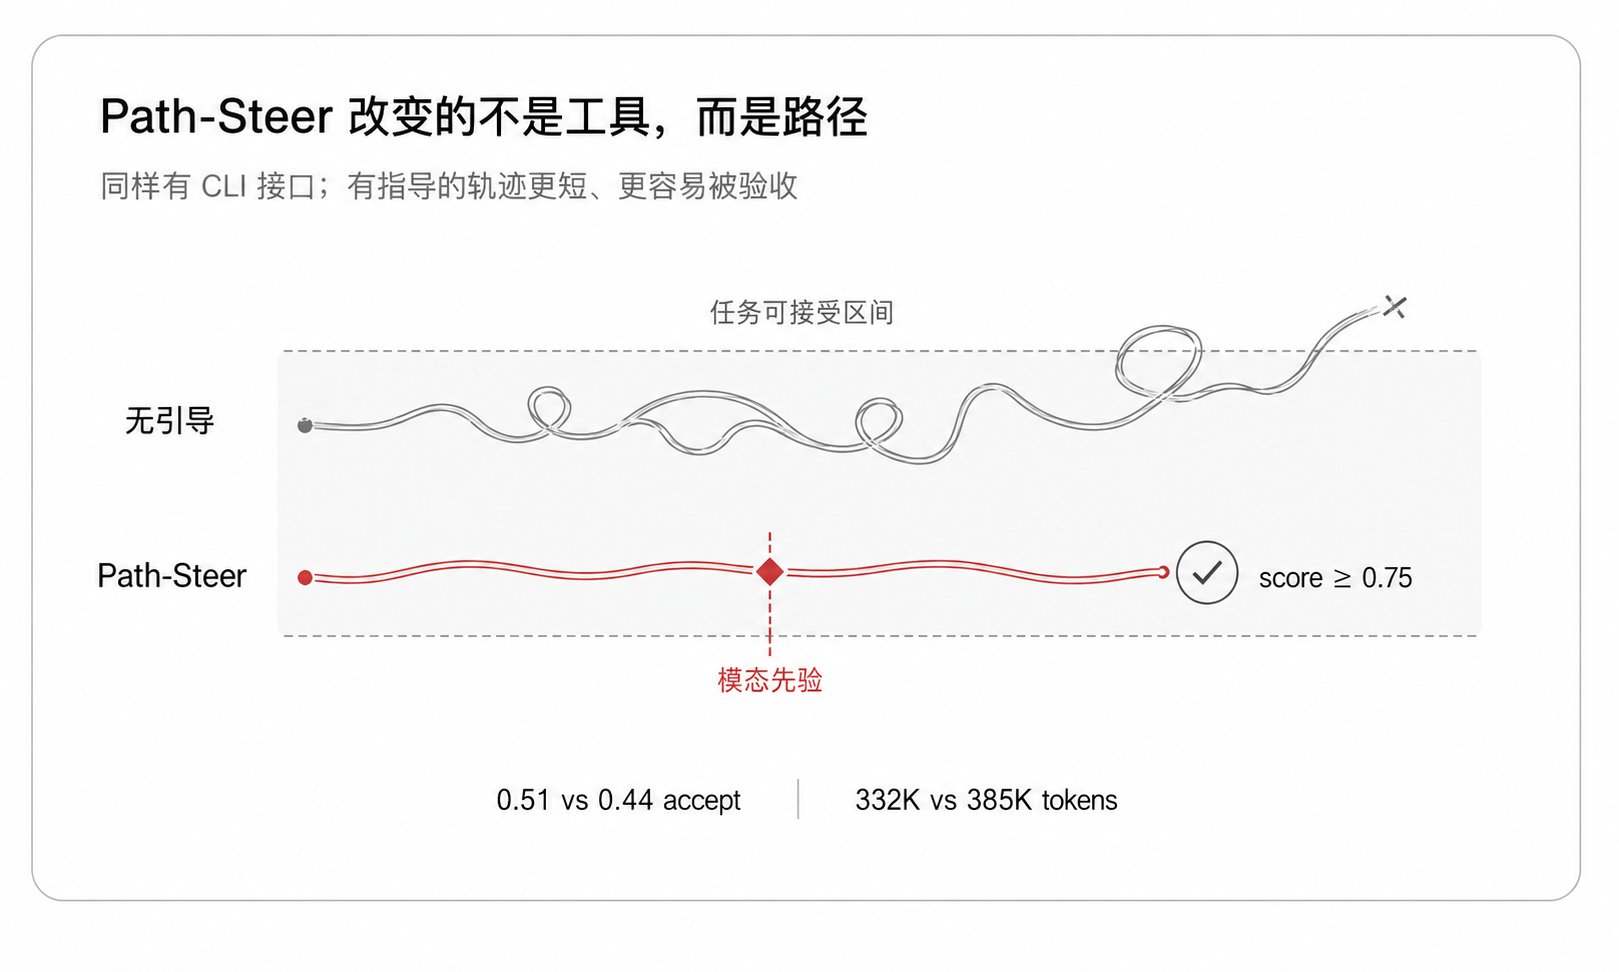
Path-Steer 的干预很轻。它从任务的 operation chain 推出一个“混合执行先验”:哪些操作适合 CLI,哪些操作适合 GUI。这个先验提供的是 modality-level guidance,不是低层动作脚本。换句话说,它不告诉 agent “点击第几个按钮”,而是提示路径应该往哪里走。
论文用 320 个合成任务做了消融,比较有 Path-Steer 和无 Path-Steer,但两边都有相同的 GUI+CLI 接口。这样就能隔离“指导本身”的作用。
在 Kimi K2.5 数据生成 backbone 上,Path-Steer 把接受率从 0.44 提高到 0.51,平均分从 0.63 提高到 0.71;平均步数从 26.68 降到 22.75,tokens 从 385,107 降到 331,988,单任务估算成本从 0.31 美元降到 0.26 美元。
换成 Seed2.1 Pro,趋势也一致:接受率从 0.45 到 0.54,平均分从 0.67 到 0.75,步数、tokens、成本都下降。
这组结果很关键,因为无 Path-Steer 的 baseline 不是 GUI-only,它已经有同样的 CLI。差别只在于有没有路径级的模态指导。因此论文可以更有把握地说:提升不只是因为“命令行更快”,而是因为 agent 被引导去形成更合理的跨界面路径。
附录里的 VLC 例子也提醒我们,不要把 Path-Steer 理解成每一步都更顺。带 Path-Steer 的轨迹早期也尝试了几次无效的 VLC CLI 参数,但它及时切换到 ffmpeg 的可行方案,最终导出正确旋转的视频并打开音频效果面板。无引导轨迹则沿着更直觉的 GUI 流程,在滤镜配置阶段反复搜索和无效交互,最后失败。
它改善的是全局收敛,不是保证局部没有试错。
训练结果:9B 模型学到的是什么
训练数据规模不算夸张,但结构很明确。论文保留 VLM judge 分数不低于 0.75 的轨迹,得到 4,923 个 verified episodes,约 235K step-level records,总大小 286.64GB。按 split 看,CUA-Verse 部分 2,526 episodes / 140,088 step records,OSWorld 部分 2,397 episodes / 95,320 step records。
模型是 Qwen3.5-9B,LoRA 微调 3 个 epoch,8 张 A100 大约两天。训练轨迹来自 Kimi K2.5 backbone 在 Path-Steer 下的高分 rollout。也就是说,这不是一个从零训练的大模型故事,而是一个“把高质量混合交互轨迹蒸馏到 9B 模型里”的故事。
在 CUA-Verse 上,未调优 Qwen3.5-9B 的 score 是 0.189,平均 56.2 步,643K tokens。训练后的模型达到 0.582,平均 35.2 步,255K tokens。论文总结为 score 约 3 倍提升,步数少 37%,tokens 少 60%。它超过 Kimi K2.5 的 0.522,也超过 EvoCUA-8B 的 0.330,只落后于 Seed2.1 Pro 的 0.599 和 GPT-5.5 的 0.768。
更细的应用分布也有信息量。训练后模型在 Audacity 上达到 0.815,在 OBS 上 0.605,音视频应用最强;Blender 0.398、Godot 0.460,相对弱。论文把这解释为 3D / 空间数据覆盖还有空间。这个边界很重要:CUA-Universe 确实教会了一些混合执行能力,但不同软件类型的难度和数据覆盖仍然会决定上限。
在 OSWorld 上,训练后的模型 GUI+CLI 成功率 40.2%,比自己的 GUI-only 23.4% 高 16.8 个百分点;平均步数 28.6,tokens 286.5K,是所有比较 agent 里 token 和 step 成本最低的一档。它没有超过 EvoCUA-8B 的 43.3%,但远高于基座 Qwen3.5-9B 的 24.6%。
这里的重点不是“9B 打败所有闭源模型”——没有。闭源 GPT-5.5 仍然有 68.0%。重点是,同样大小的基座在学过混合轨迹后,行为模式发生了可测量变化:它不再只是多一个工具入口,而是真的把 CLI 用进解决路径。
附录的 action-modality 统计很直观。Qwen3.5-9B 在 CUA-Verse 上 CLI 使用率是 0.0%,score 0.189;训练后 CLI 使用率升到 25.3%,score 0.582,步数下降到 35.2。EvoCUA-8B 虽然有 CLI 接口,却只有 3.0% CLI 使用率,score 0.330。GPT-5.5 的记录里 CLI 使用率是 100%,score 0.768,但也没有满分。
这说明“更多 CLI”不是充分条件。有效的是根据任务选择模态,而不是把所有事情都命令化。
迁移到 OSWorld-MCP:学到的是格式,还是能力?
如果模型只记住了 CUA-Universe 里的应用命令,那它换一个工具接口就应该失效。
论文用 OSWorld-MCP 做了这个测试。OSWorld-MCP 给 OSWorld 增加了 158 个 MCP tools,允许 agent 自由组合 GUI 和工具调用。它和 CUA-Universe 训练时的 application-specific CLI 不是同一个动作空间。
在 244 个排除 os 和 multi_apps 的任务上,训练后模型的 Score 是 29.51%,Strict SR 是 28.69%,TIR(工具使用决策准确率)是 23.36%,ACS 是 27.25,tokens 是 87.95M。基座 Qwen3.5-9B 则是 Score 21.67%、Strict SR 20.90%、TIR 10.66%、ACS 37.22、tokens 125.68M。
换句话说,训练后模型没有见过 MCP 格式,但 SR 提升 7.79 个百分点,TIR 超过翻倍,步数减少 27%,tokens 减少 30%。这支持论文的一个核心判断:CUA-Universe 学到的至少部分是跨界面编排能力,而不只是某组命令的记忆。
当然,迁移不是无限的。Kimi K2.5 在这个表里的 SR 是 35.25%,GPT-5.5 是 29.92%,训练后的 9B 模型还没有到最强闭源模型水平。它证明的是“小模型可以通过环境生成的混合轨迹获得可迁移的工具使用行为”,不是证明小模型已经全面超过大模型。
论文证明了什么,没有证明什么
这篇论文最扎实的地方,是把“混合 GUI+CLI agent”从一个直觉变成了可构造、可训练、可评估的 pipeline。
它证明了几件事。
第一,真实桌面软件可以被规模化改造成共享状态的双接口环境。至少在论文覆盖的 16 个开源或可脚本化桌面应用上,App-Forge 能生成 VM、工具注册表和约 404 个 agent-visible commands。
第二,从这些环境里可以合成不是玩具的混合任务。CUA-Verse 的 160 个任务跨 8 个应用,平均 5.7 个抽象工具,59% CLI,每个应用都需要 GUI 和 CLI 的组合。
第三,路径级模态指导能提高 rollout 质量。Path-Steer 在 320 个任务上,对 Kimi K2.5 和 Seed2.1 Pro 都提高接受率和平均分,同时降低步数、tokens 和成本。
第四,用这些高分轨迹微调 9B 模型,可以明显改变 agent 的行为和效率。CUA-Verse 上从 0.189 到 0.582,OSWorld 上 GUI+CLI 从 23.4% 到 40.2%,OSWorld-MCP 上相对基座也有迁移提升。
但它也没有证明几件事。
第一,它还没有覆盖跨应用 workflow。论文的限制部分明确说,当前任务是 single-application tasks。现实办公里很常见的是浏览器找资料、Zotero 管引用、Writer 写文档、邮件发送结果。状态跨多个应用流动,比单应用共享状态更难。
第二,训练方式仍然是 supervised fine-tuning。轨迹来自 Kimi K2.5,过滤后蒸馏到 Qwen3.5-9B。论文也承认,学到的 policy 受数据生成 backbone 限制;下一步可以把 verifier 用作 RL reward。
第三,成功判定依赖 VLM judge,而不是每个任务都有程序化 verifier。论文对此做了人类标注验证:16 个应用中,每个应用抽 30 个 judge accepted 和 30 个 rejected 轨迹,三位标注者盲评。接受集 precision 99.0%,没有一个 accepted trajectory 是人类标注的 hard failure;重加权 agreement 97.0%,Cohen's kappa 0.94。这很强,但仍然不是“零噪声”。
第四,环境假设还比较理想。应用需要开源或至少足够可脚本化,环境目标是 desktop Linux。闭源桌面软件、移动端、浏览器云应用、企业内网工具,都会引入新的适配和验证问题。
这些边界不削弱论文价值,反而让它更清楚:CUA-Universe 的贡献不是宣称“电脑智能体问题已经解决”,而是指出一个可扩展的训练轴——不要只收更多 GUI 点击轨迹,也不要只给模型一堆工具文档;要把真实软件变成能持续产生混合任务和混合轨迹的环境。
更大的意义:agent 训练要从“看屏幕”走向“操作系统”
过去两年,computer-use agent 的直觉路线很像教一个人看屏幕:给截图,给鼠标键盘动作,让模型学会点按钮。这条路线当然重要,因为大量任务确实发生在 GUI 里。
但真正的电脑使用从来不是纯视觉行为。文件系统、配置文件、脚本接口、应用内部数据库、导出 artifact、命令行工具,都是电脑状态的一部分。人类高手的效率,往往来自知道什么时候不要点界面。
CUA-Universe 把这个事实放进训练环境里。
它不是简单地说“CLI 更快”,而是把 GUI 和 CLI 都绑定到同一个可验证状态:GUI 用来观察布局、确认对象、处理视觉依赖;CLI 用来批量、精确、高吞吐地改写状态;Path-Steer 则把这种分工变成可以被蒸馏的轨迹。
如果这个方向继续往前走,未来的 computer-use agent benchmark 可能不会再只问“它能不能完成这个界面任务”,而会问更接近真实生产力的问题:它能不能理解一个应用状态,选择合适的操作面,在多个界面之间保持一致,并用 artifact 证据证明自己真的完成了任务。
这也是 CUA-Universe 最值得关注的地方。它把 agent 的学习对象,从单个界面上的动作,推进到真实软件生态里的可执行路径。对于想让 AI 真正接管复杂桌面工作的研究者来说,这可能比又一个更大的 GUI 模型更重要。