AutoDesign:让 AI 反复优化自己的设计工作台
我们先想一个很具体的场景。
一个 AI agent 收到一篇论文,要把它变成会议海报。它不是简单把摘要贴上去。它要读 PDF,找主要贡献,挑图表,判断哪些数字必须保留,写标题,排版,渲染,再看有没有文字溢出、图表太小、证据断裂。
第一版通常会有问题。可能图太密,可能结论没有来源,可能标题漂亮但正文读不动。于是我们让另一个 critic 看一遍,给反馈,designer 再修。几轮之后,一张海报终于能交付。
这已经是今天很多设计 agent 的基本套路:生成、批评、修改。
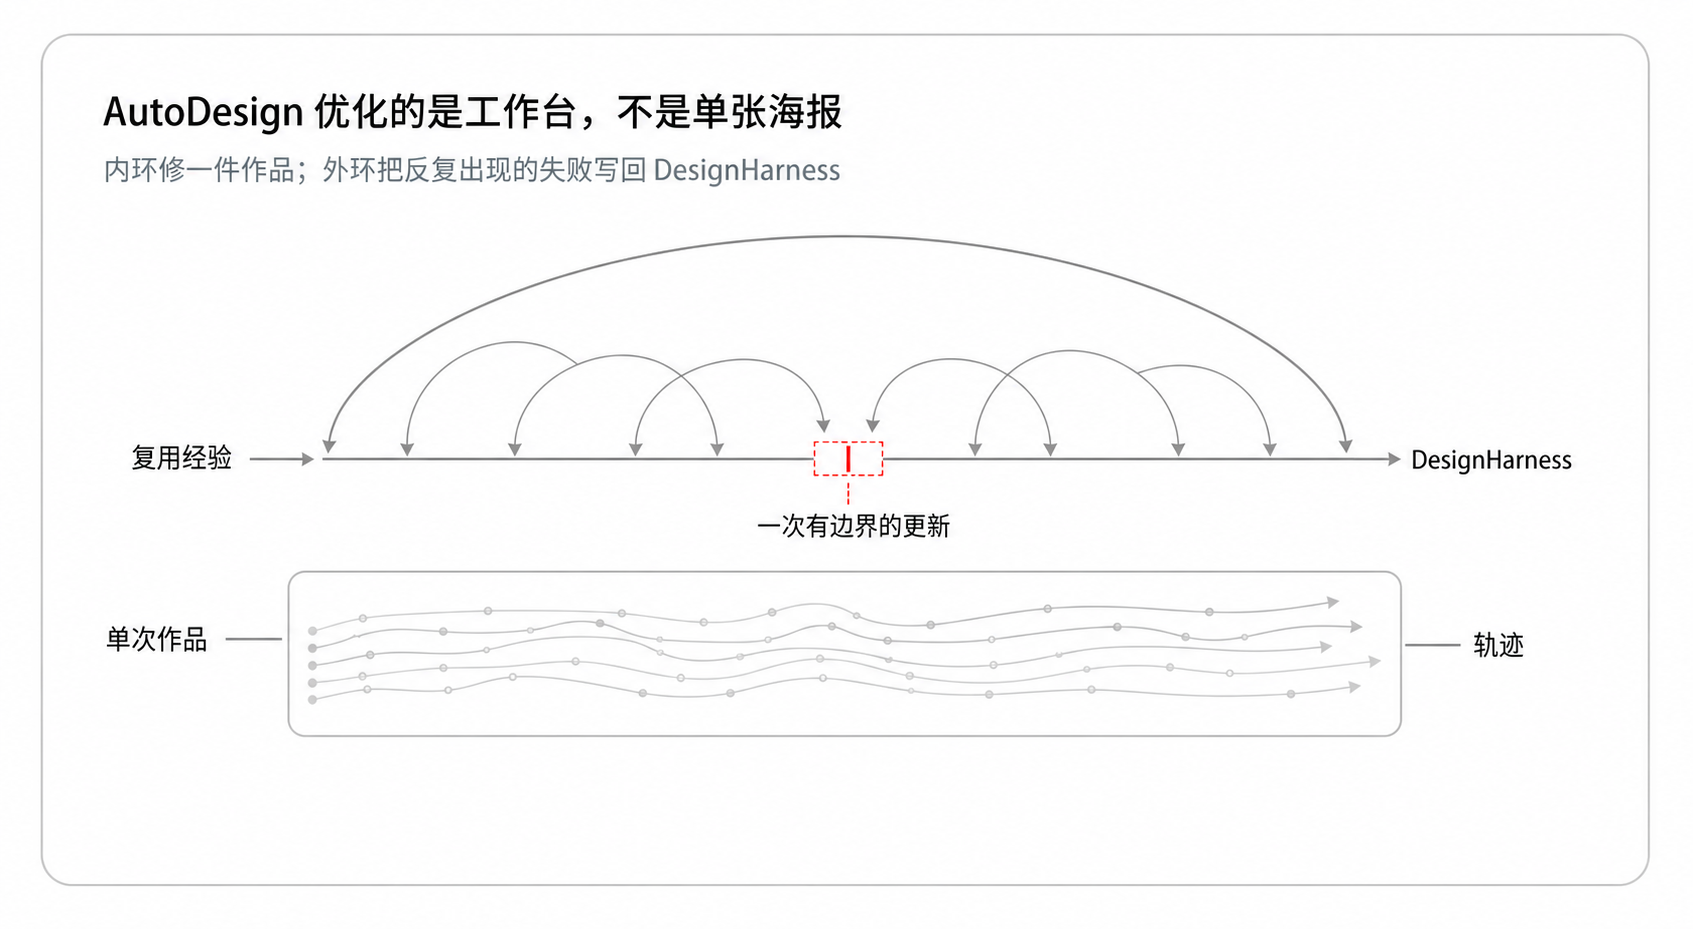
但 AutoDesign 这篇论文问的是另一个问题:如果同一种错误在十张、二十张、上百张海报里反复出现,我们为什么只修当前这一张?为什么不把“这类错误怎么避免”写回生成系统本身?
这就是论文最核心的转向。它不把目标放在“生成一张更好的海报”,而是放在“让生成海报的工作台变得更好”。论文把这个工作台叫 design harness,把优化工作台的外层系统叫 meta-harness。
先理解:harness 不是 prompt,而是一整套工作环境
我们平时说“给模型加一个 harness”,容易把它想成一段提示词。比如告诉模型:请保持忠实,请注意排版,请不要编数字。
但在 AutoDesign 里,harness 要厚得多。
一篇论文进来,系统先要把源材料整理成可用上下文:标题、作者、章节结构、关键段落、图表、数字、每个 claim 对应的证据位置。这不是模型权重里的东西,而是工作流里的记忆与上下文。
然后它需要一套可编辑的产物规格。论文实例里,最终海报不是一张不可改的图片,而是 HTML 这类可编辑 artifact。这样 designer 可以局部改一块布局,而不是整张图重新生成。
它还需要运行环境:文件、浏览器、渲染器、导出工具、检查脚本。海报是否溢出,图片是否丢失,来源链接是否断掉,这些很多不是靠“感觉”发现的,而是靠执行环境里的 validator 抓出来。
再往外,还有编排逻辑:最多修几轮,什么时候停,失败时选哪一个候选,哪些问题必须阻塞,哪些问题可以降级处理。
最后才是评价与反馈:规则检查、视觉模型 critique、局部诊断、下一轮修改建议。
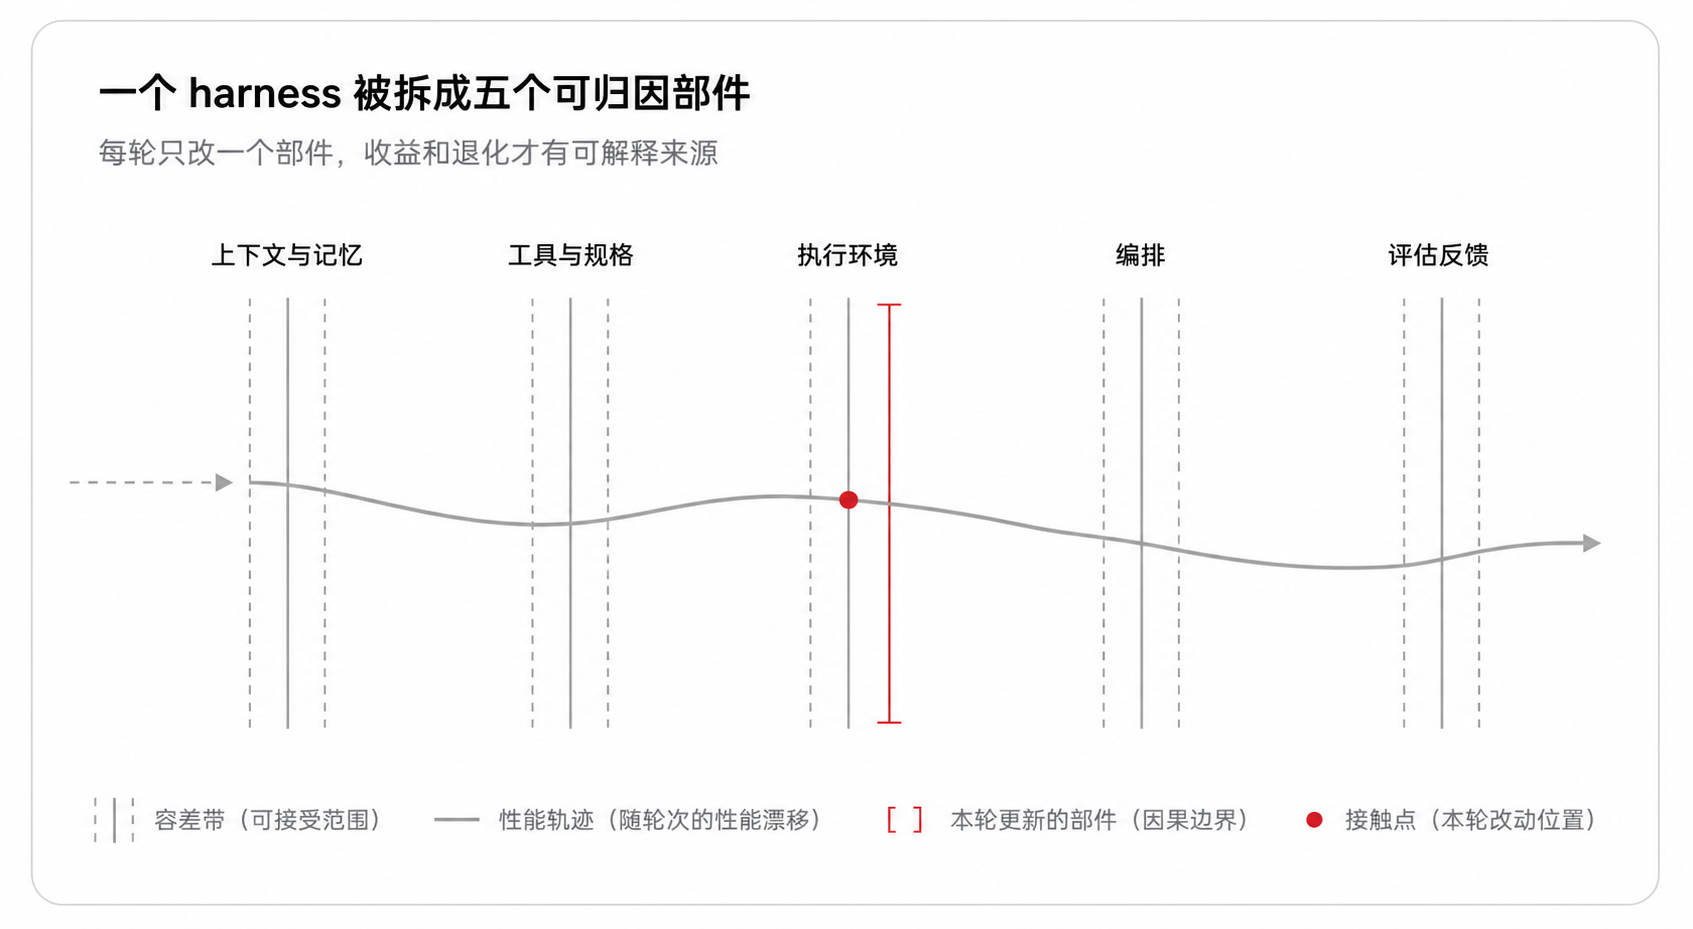
论文把 design harness 拆成五个部件:Context and Memory、Tools and Specifications、Execution Runtime、Orchestration、Evaluation and Feedback。这个拆法看起来像工程分类,但它决定了后面优化能不能归因。
如果一次外层更新同时改 prompt、改渲染器、改 critic、改 fallback,分数涨了,我们不知道是谁起作用;分数跌了,也不知道该撤回哪里。AutoDesign 的外环每次只允许更新一个部件。一个 candidate harness 必须在训练任务上变好,并且在开发任务上不退化,才会被接受。
内环修作品,外环修系统
理解 AutoDesign 最简单的方法,是把它看成两层循环。
内环处理一篇论文。designer 先生成一个候选海报,critic 和 validator 看它哪里坏了,再把局部反馈交回 designer。论文给出的形式化写法是:第 k 步的 artifact 由上一版 artifact、上一轮反馈、源材料和设计上下文共同决定;critic 再对当前 artifact 产生新的反馈。这个过程只改变当前作品,不改变 harness 本身。
外环看很多次内环留下的轨迹。它不是盯着某一张海报说“这里字太小”,而是问:这些轨迹里有没有反复出现的失败模式?比如来源证据总是离结论太远,浮动图旁边的列表总是挤坏,或者视觉 critic 总是太晚才发现标题区域被压缩。
外层 optimizer 是一个 coding agent。它先以 planner 身份读轨迹、读分数、读历史记录,派子 agent 检查失败;然后提出一个有边界的 harness 更新计划;再以 code editor 身份真正修改 harness。修改之后,新 harness 在训练集和开发集上重新跑。训练集更好、开发集不差,才进入下一代。
这和“自我反思”有一个关键区别。
普通反思常常把经验写成一段文字:下次注意布局,图表要更大,信息密度要更高。AutoDesign 追求的是把经验落成可执行系统:一个新的检查、一个更具体的来源组织方式、一个候选选择策略、一个渲染后修复门。经验不是留在日志里,而是进入下一次生成的工具链。
论文报告,在 7 天演化轨迹里,系统调用了 224 个 subagents,记录至少 123 次递归迭代,累计 54 个 harness updates。这个数字不是为了炫耀“跑了很久”,而是说明它研究的对象确实是长程系统优化,而不是单轮 prompt search。
为什么选 paper-to-poster:因为它刚好难在“证据”和“可读性”之间
AutoDesign 没有从泛泛的“多模态设计”开始做评测,而是落在 academic paper-to-poster。
这个任务很适合检验 design harness。
它首先需要忠实。海报里的数字、方法、结论不能凭空编;图表最好来自论文,或者能被论文支撑。它还需要覆盖。只放一个漂亮结论不够,要让读者知道问题、方法、证据和 takeaway。
但它又不能像论文摘要一样堆字。海报是视觉 artifact。信息密度、留白、层级、阅读路径、图表解释、字号、边距,都会影响人能不能读。一个系统可能很忠实,但做成密密麻麻的截图墙;也可能很漂亮,但把证据弄丢。
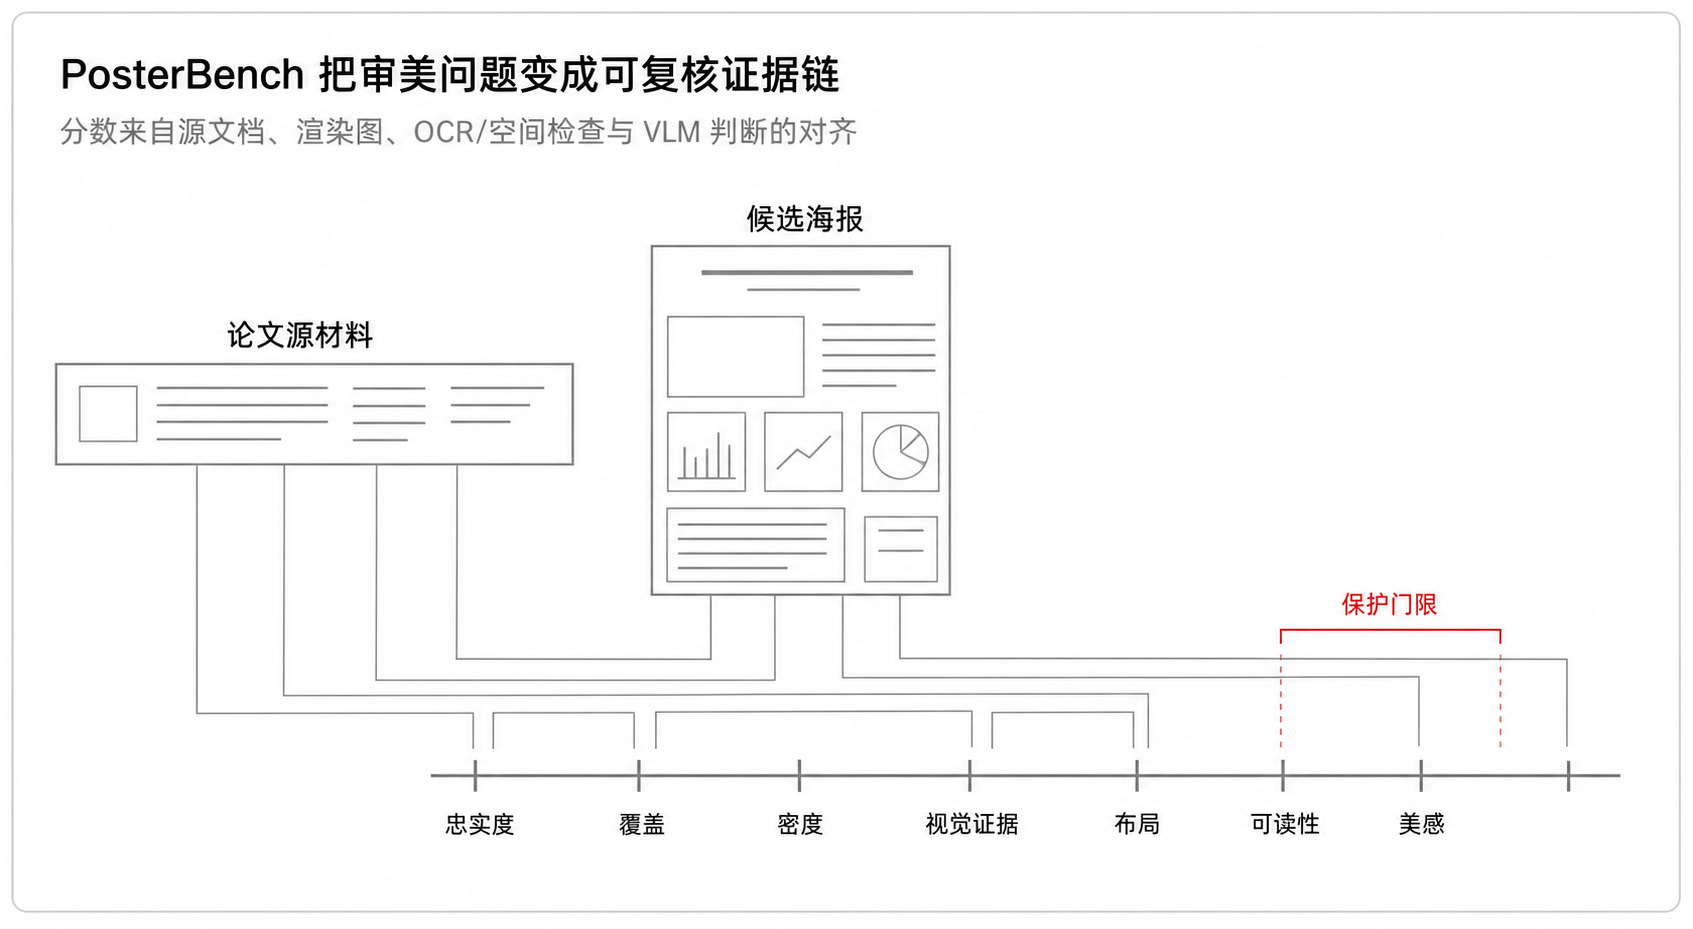
这就是论文提出 PosterBench 的原因。它包含 100 篇主榜论文,覆盖 AI/ML、生物医学与健康、气候与地球环境、经济与政策、物理与天文五个学科;另有 10 篇 PosterBench-mini,用于受控实验。
PosterBench 的评分不是一个 VLM 随口打分。它有七个维度:忠实度、覆盖、密度、视觉证据、布局、可读性、美感,权重分别是 10、10、15、10、20、25、10。与此同时,它还有记录级 ceiling:严重布局损坏、展示不可用、可见失败、渲染完整性问题,会把总分封顶。论文特别提醒,表里的维度均值不能简单按权重反推 Overall,因为封顶是在单个海报层面先发生的。
这个设计很重要。否则系统可以在某些维度拿高分,同时留一个致命问题。例如整体好看,但关键图表缺失;或者文字看似完整,但有明显来源不一致。保护门限让这些硬失败不会被平均分掩盖。
数字说明了什么:AutoDesign 强,但不是魔法
主榜结果很直接。
在 100 篇 PosterBench Main Track 上,AutoDesign + DesignHarness + Claude Code + Claude 4.8 得到 78.32 分,是表中最高;同一 Claude Code / Claude 4.8 配置下,它比 Claude Design 高 7.45 分,比 OpenDesign 高 8.87 分。另一个 AutoDesign 配置,Codex + GPT-5.5,也有 77.97 分。
如果只看 coding agent baseline,Codex + GPT-5.5 是 73.37,Claude Code + Claude 4.8 是 70.01。也就是说,强模型和强 coding agent 本身已经能做不少事;DesignHarness 的作用不是凭空制造能力,而是把这些能力放进更稳定的设计流程里。
最能说明这一点的是 harness attachment ablation。论文在 10 篇 PosterBench-mini 上,把模型和 coding agent 固定,只比较有没有 DesignHarness。七个完成配置全部提升,提升范围是 5.01 到 19.56 分。
Codex + GPT-5.5 从 75.87 到 81.46,涨 5.59。Claude Code + Claude 4.8 从 69.55 到 74.56,涨 5.01。Seed 2.1 Pro 从 54.01 到 71.83,涨 17.82。DeepSeek V4 Pro 从 34.73 到 54.29,涨 19.56。
这里有一个有意思的现象:越强的基础组合,绝对分数越高,但 harness 带来的边际提升不一定最大;较弱模型在没有好工作流时更容易崩,给它一个稳定的来源组织、渲染检查和修复流程,收益可能更大。
成本结果也给了一个现实维度。在 PosterBench-mini 的七个 AutoDesign 模型配置里,经验 Pareto frontier 从 LongCat-2.0 的 55.13 分、约 0.27 美元每张,到 Seed 2.1 Pro 的 71.83 分、2.75 美元,再到 Claude 4.8 的 74.56 分、7.63 美元,最后到 GPT-5.5 的 81.46 分、10.02 美元。论文写到,Seed 2.1 Pro 以 GPT-5.5 约 27% 的成本达到其 88% 的分数。
这让 AutoDesign 不只是一个“最高分系统”,也像一个可调的生产方案:你可以把预算、质量和模型选择放在同一个坐标系里看。
人类盲评支持了方向,但也暴露了评价边界
自动评分如果没有人类验证,很容易变成自说自话。AutoDesign 做了系统盲评:11 名志愿评审,在 100 篇源论文上比较 AutoDesign、Claude Code、OpenDesign、Claude Design 的海报。评审只看到同一篇论文的两张匿名海报,不知道系统身份。
最终有 936 个回复,其中 933 个有效排序、3 个 skip。Bradley–Terry 模型显示,AutoDesign 对均匀采样对手的胜率估计最高,为 64.0%,95% 区间是 55.2% 到 77.8%。它对 Claude Code 的 tie-adjusted preference 是 61.3%,对 OpenDesign 是 63.1%,对 Claude Design 是 67.6%。
这支持了一个结论:PosterBench 高分不是完全脱离人类偏好的指标游戏。至少在这组比较里,人类也更常选 AutoDesign。
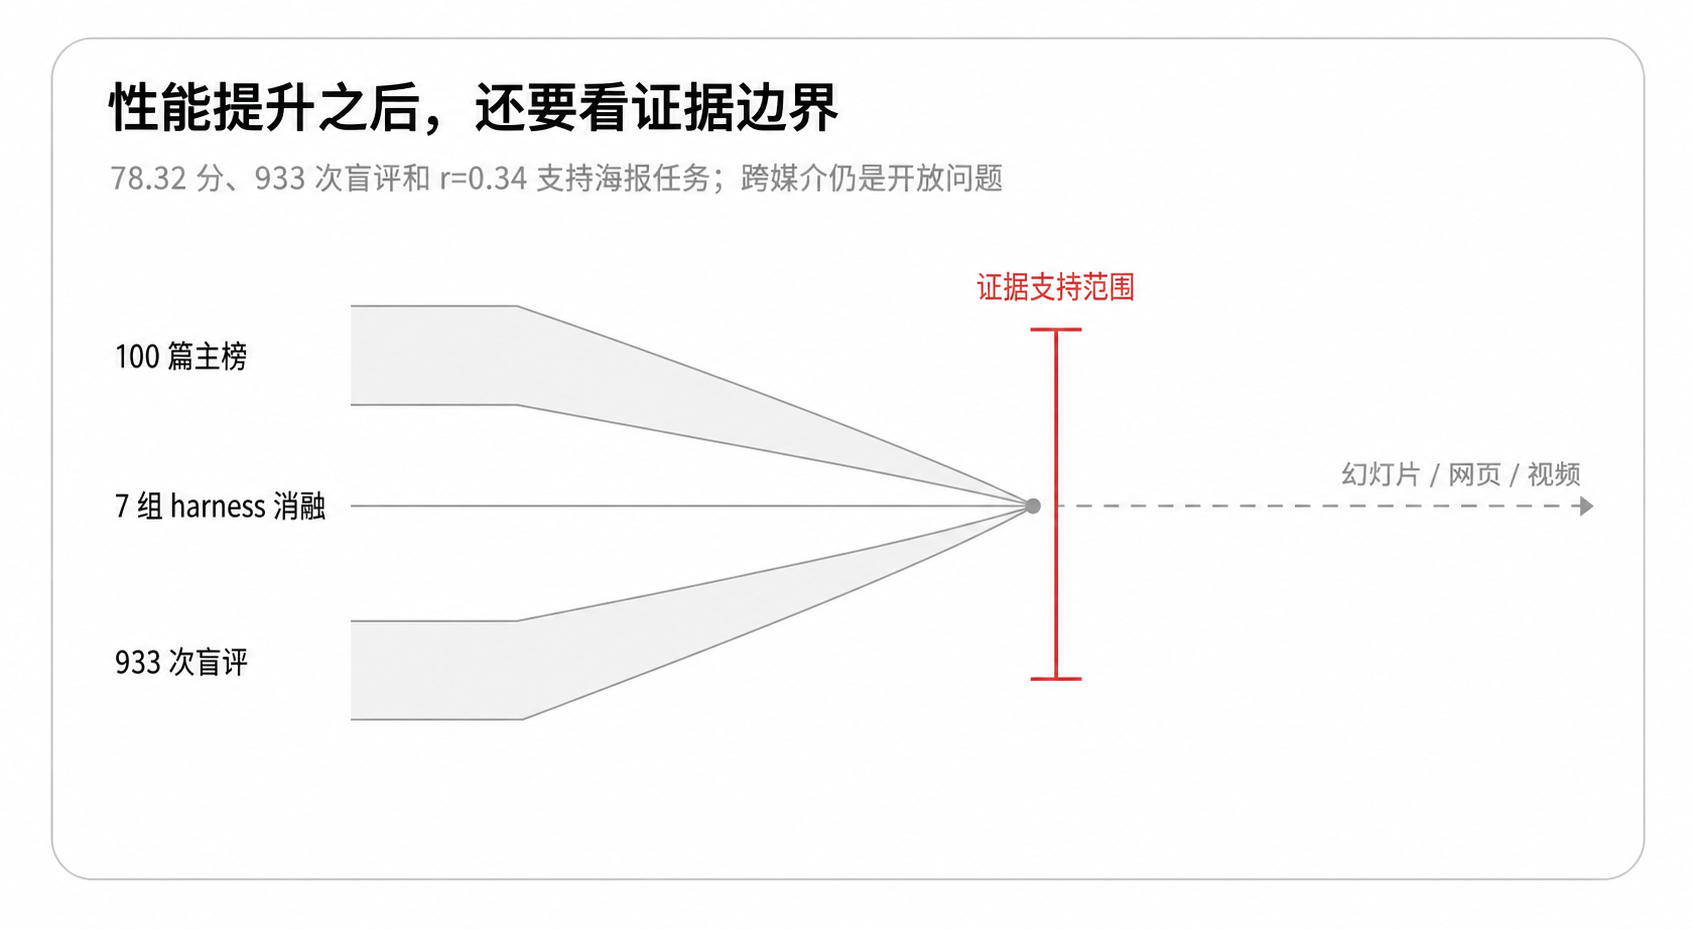
但论文没有把这件事说过头。PosterBench 与人类偏好的海报级相关只有 r=0.34,bootstrap 95% 区间是 0.22 到 0.44。这是正相关,但不是强到可以替代人类审美。
更细的结果反而更有用:当两张海报的 PosterBench 分差只有 0 到 3 分时,人类同意 benchmark 偏好的概率是 51.9%,几乎接近抛硬币;当分差至少 20 分时,这个概率升到 74.4%。换句话说,PosterBench 更适合判断“大差距”,不适合把 1 分、2 分差距解释成稳定的人类偏好。
论文真正有启发的地方:agent 改进可以发生在模型之外
过去我们讨论 AI 系统变强,常常默认路径是训练模型:更多数据、更大参数、更好的 RL。AutoDesign 展示了另一个层次:固定模型,优化模型周围的 harness。
这不是小修小补。对于长程 agent 任务,很多失败并不来自“模型完全不会”,而来自系统没有给它稳定的上下文、没有可编辑产物、没有局部反馈、没有好的停止条件、没有把过去错误变成下次默认行为。
人类设计师也是这样成长的。不是每做一张海报都从零开始,而是慢慢形成工作习惯:哪些图必须靠近结论,哪些布局一定会挤爆,什么字号在投影上读不清,什么颜色组合会让层级消失。AutoDesign 尝试把这种“经验变成工作台”的过程自动化。
它的边界同样清楚。
第一,实验证据主要在 academic paper-to-poster。论文展示 DesignHarness 已经能做 slide、webpage、conference video 的 pilot artifact,但正式评测是 PosterBench。跨媒介可靠性还不能从海报结果直接推出。不同媒介需要不同数据、评价器、渲染门和目标。
第二,评价器本身可能成为优化目标。AutoDesign 外环用的 R_meta 在优化期间固定,最终评测用 PosterBench 也是冻结协议。这降低了 reward hacking 风险。但论文未来方向也承认,如果评价器要自适应演化,就必须版本化,并用冻结参考任务、对抗 probes 和周期性人工审计锚住,否则系统可能学会优化一个移动且有偏的裁判。
第三,论文证明的是 harness 优化在这个任务和这些系统配置下有效,不等于所有 agent 工作流都可以靠同样外环稳定自改。尤其是安全敏感任务里,自动修改工具链、评价器和执行策略会引入新的治理问题。
所以 AutoDesign 最值得带走的不是“AI 会自动做漂亮海报”,而是一个更一般的工程判断:当 agent 的任务变成长程、可执行、带反馈的生产流程时,真正应该被优化的对象,往往不是单次回答,而是围绕模型的工作系统。
内环让作品变好。
外环让下一次作品更容易变好。
这中间的差别,就是 AutoDesign 这篇论文的价值所在。