模型升级之后,Agent 的记忆还活着吗?
一个 agent 用了一年之后,最值钱的东西不一定是模型本身。
模型可以换。今天为了成本换成小模型,明天为了长上下文换成另一个模型,后天因为供应商策略再换一次。真正难搬的是它在一年里攒下来的东西:用户偏好、项目约定、过去的工具结果、某个仓库里不能碰的边界、上次讨论到一半的任务。
直觉上,我们会把这件事想得很简单:记忆不是已经存在数据库里了吗?升级模型时,把数据库原样接给新模型,不就完成迁移了吗?
这篇论文问的正是这个看似无聊、但非常危险的问题:如果旧模型写下来的记忆还在,新模型读它时,agent 真的没有忘吗?
论文的回答很不舒服。数据库可以照常返回,向量维度可以完全匹配,服务可以没有任何报错,但性能仍然会掉。因为长期记忆不是一个被动文件夹。它是 agent 行为链条的一部分:谁把历史写成记忆,谁负责检索,谁读取,谁修复,每一环都会决定未来模型能不能重新拿到当初的证据。
先把“记忆迁移”这件事拆开
我们先不用论文里的术语,想一个很普通的工作流。
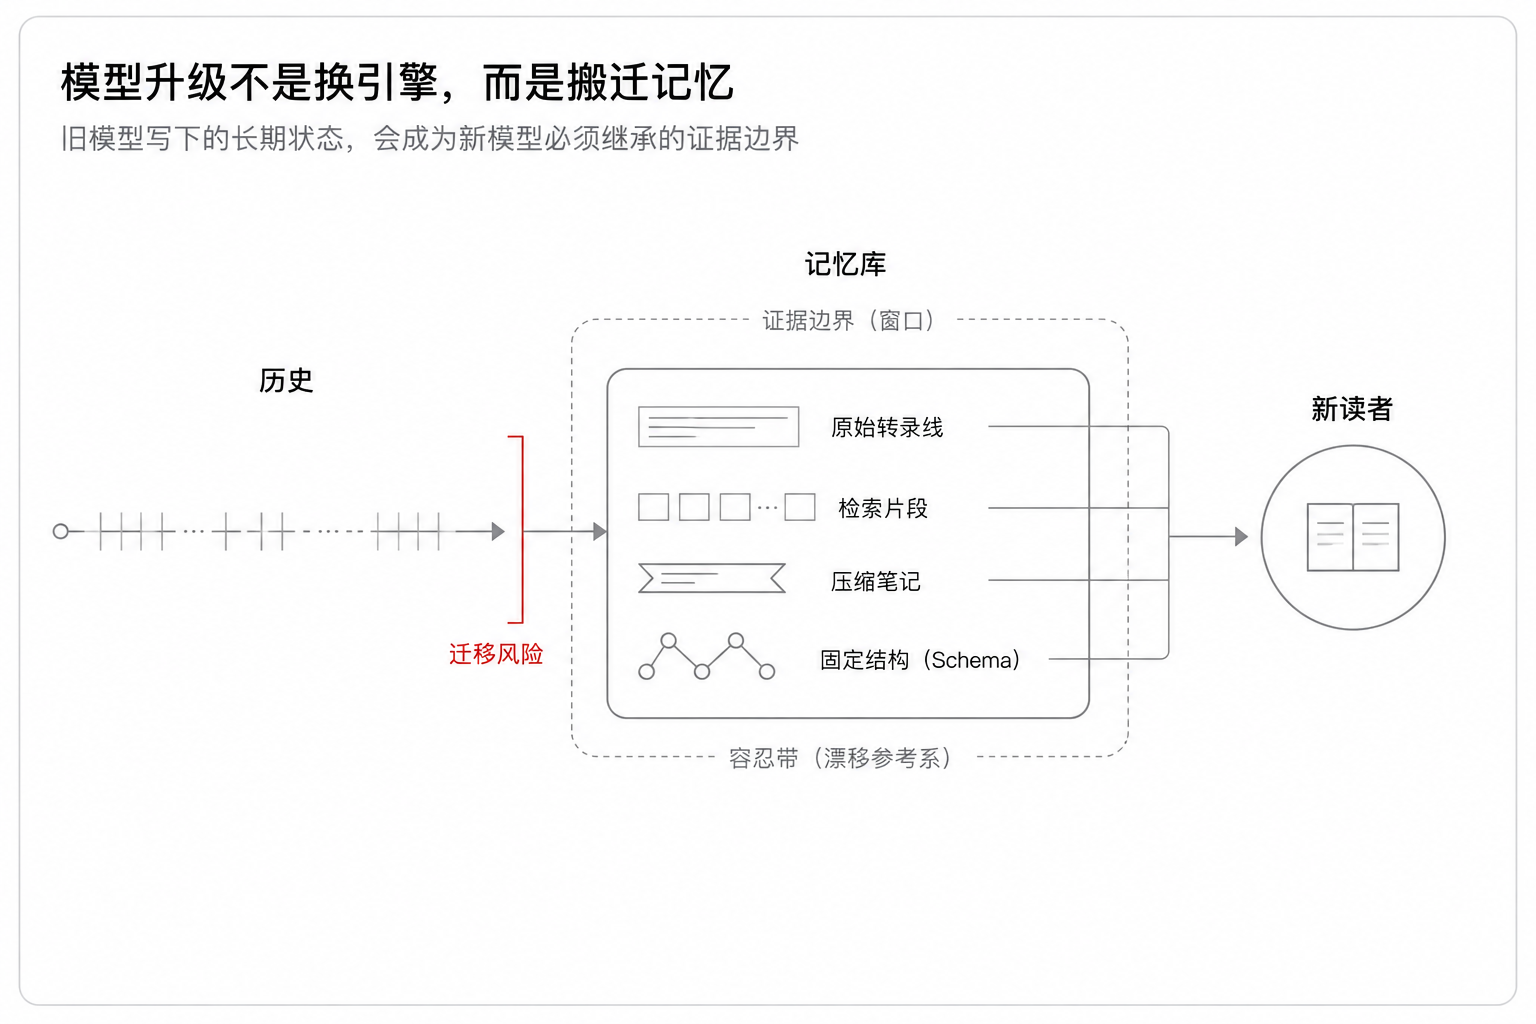
一个 agent 和用户合作了很多轮。原始对话很长,不能每次都塞进上下文。于是系统会在后台留下一份外部记忆。最朴素的做法,是把完整历史保存下来;更省上下文的做法,是把历史切成块,查询时用 RAG 找几段相关内容;再进一步,可以让模型把历史压缩成一组自然语言笔记;或者把事实写进固定 schema 的知识图谱,例如“项目 A -- 截止日期 -- 某个值”。
表面上,这四种都叫 memory。实际上,它们保存的东西完全不同。
完整历史保存的是源证据。RAG 保存的也是原文片段,但读取前要先过检索。自然语言笔记保存的是一个模型压缩后的解释,哪些事实被保留、哪些被合并、哪些被省略,都由写笔记的模型决定。固定 schema 的知识图谱则牺牲表达自由,换来每条记录都必须落在预先规定的结构里。
到这里,“模型升级”就不再只是把 reader 从 A 换成 B。旧模型可能已经作为 writer 写过笔记;embedding 模型可能已经给历史片段建过索引;修复程序可能只能看到压缩后的存储,而看不到原始历史。论文把这些角色拆成 actor、writer、reader、embedder 和 repair source,目的就是避免一句“换模型后效果变差”把所有问题混在一起。
它还引入了两个很实用的度量。
第一个叫 RPAS,Retained Performance After Swap。意思是:新模型 B 读旧模型 A 写的记忆时,保留了多少“B 自己写、自己读”时的性能。这样比较很公平,因为 reader 固定是 B,差异主要来自它继承了谁写的 store。
第二个叫 CTR,Cost-to-Recover。意思是:如果迁移后记忆坏了,用什么修复方式、花多少预算,能恢复到新模型自己建库性能的 90%、95% 或 99%。这比单纯报告 accuracy 更接近工程问题:坏了之后能不能救,救回来要靠什么证据。
为什么论文不用真实聊天记录
真实用户历史当然更像生产环境,但它也会把很多变量搅在一起。
如果 agent 记错了一个人的偏好,我们很难判断原因。可能旧模型写笔记时漏了;可能检索没找回;可能新模型看到了但没理解;也可能问题本身需要主观判分。更麻烦的是,普通事实有可能已经在模型预训练里见过。答对不一定说明记忆成功,答错也不一定说明记忆丢了。
所以论文选择了一套受控合成历史。它构造了 48 个 evaluation histories,每个历史有 160 个问题,覆盖直接事实、随时间变化的事实、矛盾、多步关系和别名。答案是随机代码,几乎不可能来自预训练;评分用 exact match,不需要再找一个大模型当 judge。
这让实验少了一些真实感,但换来一个关键能力:当答案错了,研究者能追问证据到底在哪一环消失。
模型也被刻意控制。论文只测试两个相近规模的开源模型:Llama-3.1-8B-Instruct 和 Qwen2.5-7B-Instruct-1M。这不是在宣称“所有模型升级都这样”,而是在做一个可复核的应力测试。每个历史都能放进两个模型的上下文,并且至少留出 4096 tokens;读取是 deterministic,写入低温固定 seed;重复 live reads 的波动只有 0.0016,远小于后面报告的效应。
更重要的是,研究者在收集主结果前保存了一个带签名的 Git tag:hypothesis-lock-v1。里面锁定了四个计划检验、五个百分点的行动阈值、Holm 校正和排除规则。论文也很诚实地说明:原计划的 bootstrap 是后来补跑的;虽然它和最初的 t-test 得到相同结论,但仍应被看成 follow-up check,而不是严格的预注册执行。
自由文本笔记的问题:方向会互相抵消
最容易误读的结果,是 NOTES 的迁移。
如果只看对称平均,NOTES 的 writer-swap penalty 没有超过论文预先设定的五个百分点阈值。H1 的估计是 -1.47 pp,Holm 调整后的 p 值是 1.0;H4a,也就是 NOTES 的 writer-swap penalty 是否显著大于 KG-fixed,也没有支持,估计是 -1.51 pp。
这听起来像是“自然语言笔记迁移没问题”。但论文真正想提醒我们的,恰好是不能这样平均。
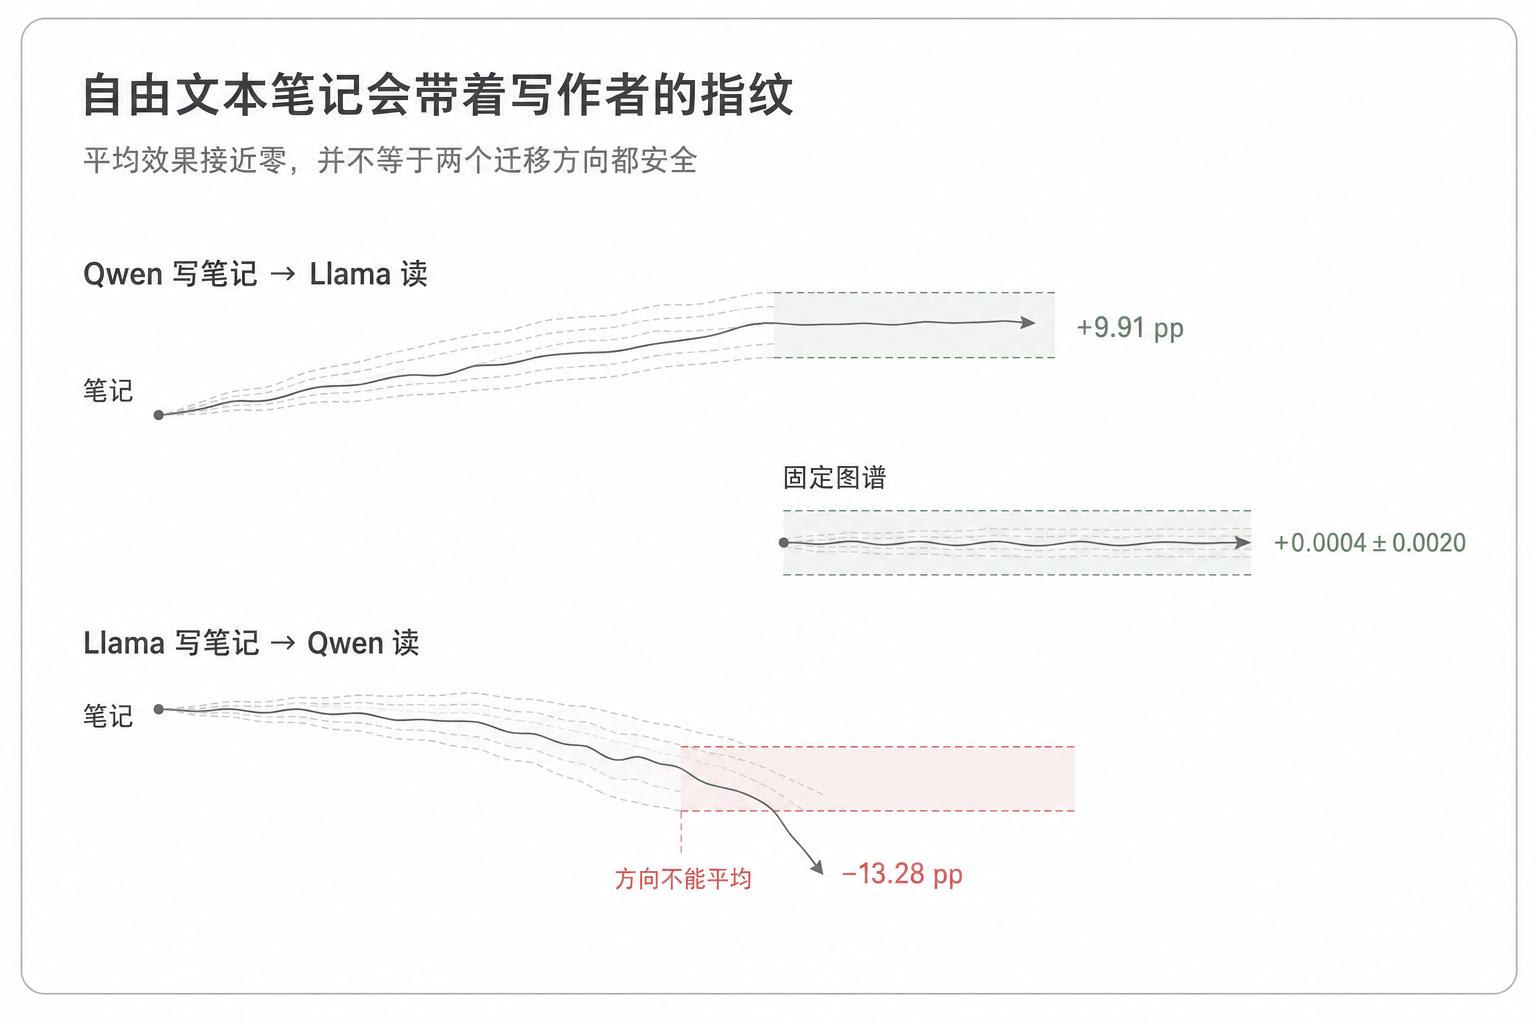
具体方向拆开之后,故事完全变了。
当 Llama 读 Qwen 写的 NOTES,accuracy 从 Llama 自己写自己读的 0.3762 变成 0.4753,反而上升 9.91 个百分点。换句话说,Qwen 写出的笔记对 Llama 更有帮助。
但反过来,Qwen 读 Llama 写的 NOTES,accuracy 从 Qwen 自己写自己读的 0.4719 掉到 0.3391,下降 13.28 个百分点。这不是小波动,而是一次明显迁移损失。
为什么平均会骗人?因为 +9.91 和 -13.28 在对称统计里会互相抵消。工程上,我们关心的不是“两个方向平均是否安全”,而是“我现在要从旧模型迁到新模型,这个方向是否安全”。如果线上旧 writer 是 Llama,新 reader 是 Qwen,那么平均值接近零对你没有任何安慰。
校准阶段也给了一个提示。在更宽松的 160 KiB sweep 里,Qwen 的 notes 用约 143 KiB 保留了 85.6% 的 required evidence spans;Llama 用约 159 KiB 只保留 64.5%。这说明差异不是谁写得更短,而是谁在压缩时保留了更多有用证据。
相比之下,KG-fixed 几乎不动。writer 换掉后,KG-fixed accuracy 的变化只有 +0.0004 ± 0.0020;Llama 端 own-store 0.8456、inherited 0.8445,Qwen 端 own-store 0.9878、inherited 0.9880。固定 schema 把关系名、字段和读取方式都钉住了,模型主要负责填值。它不是证明“所有知识图谱都比笔记好”,而是证明:当任务可以被稳定 schema 表达时,结构本身能减少对写作者风格的依赖。
RAG 的陷阱:新旧向量混在一起,系统不会报错
另一个很工程化的结果来自 embedding migration。
RAG 里,reader 其实不直接看向量。向量做的是路由:把 query 嵌入到同一个空间里,找最相似的历史片段,再把 top-k 文本交给模型。如果检索没把证据送到 reader 面前,再强的 reader 也只能空想。
论文的 RAG 设置故意朴素:event-based chunks,大约 512 字符,cosine top-k=8,没有 reranker、query rewriting 或 hybrid search。这个选择会让绝对分数不高,但它让失败来源更清楚。LC-RAW 的 accuracy 在 Llama/Qwen 上分别是 0.7121 和 0.9109,而 RAG 只有 0.5346 和 0.5647。诊断分解显示,RAG 总损失 0.450 中有 0.364 ± 0.012 来自 retrieval,占 81%;stored chunks 本身的 construction loss 只有 0.005 ± 0.005。
也就是说,在这个设置里,RAG 不是因为原文片段坏了,而是经常没有把正确片段找回来。
更危险的是 embedding 升级。论文把 BAAI/bge-large-en 从 v1.0 换到 v1.5。两个模型都输出 1024 维向量,所以旧向量和新向量可以放进同一个 index,数据库不会因为维度不匹配而报错。但“维度相同”不等于“空间相同”。
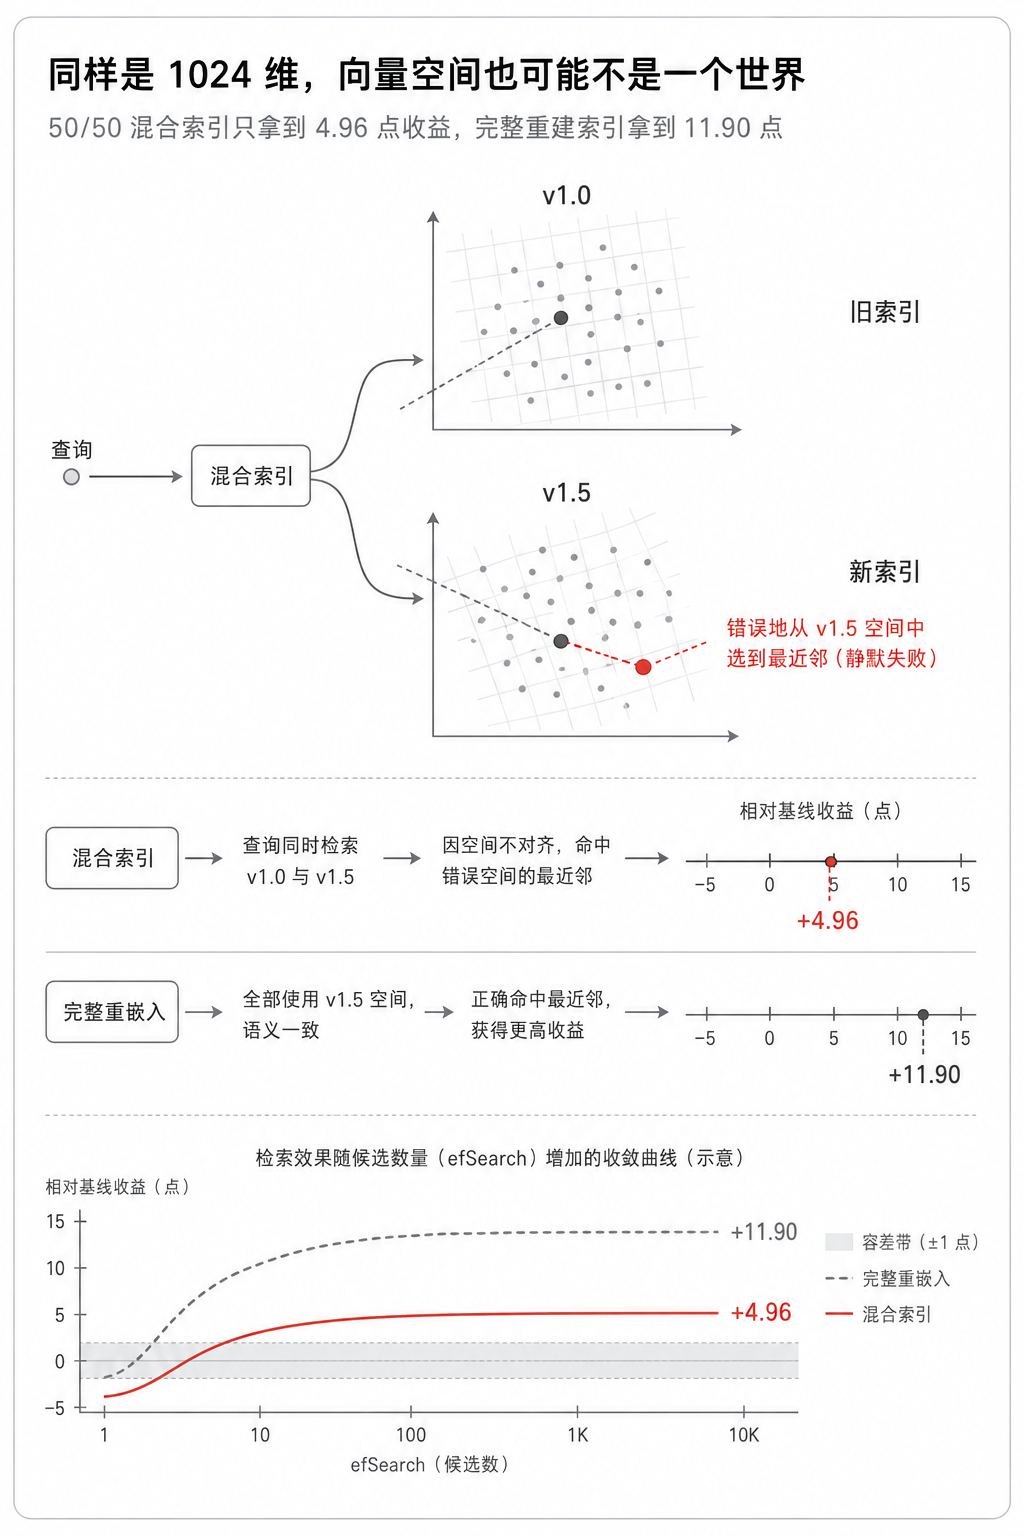
结果很清楚。旧索引 answer accuracy 是 0.4257。完整重嵌入到 v1.5 后,accuracy 到 0.5447,比旧索引高 11.90 个百分点。50/50 混合索引也有提升,但只有 0.4753,也就是 +4.96 个百分点。它拿到了不到一半的潜在收益,把多数升级收益留在地上。
如果看 recall@k 和 MRR,也能看到同样模式:full re-embed 的 recall@k 是 0.5998,mixed index 是 0.5208;MRR 分别是 0.4068 和 0.3643。ideal routing upper bound 还能到 0.5960 accuracy,但论文也强调,这只是上界,不是一个现实可部署系统,因为它假设系统已经知道答案在哪个索引里。
这给生产系统的建议非常直接:embedding 迁移不要在同一个向量空间里慢慢混。要么完整重建新索引后切流,要么把新旧向量空间隔离,并按已知版本路由。否则服务看起来在线,实际检索已经在静默退化。
修复:改写坏笔记救不回丢掉的证据
如果迁移坏了,我们自然会想修复。
对 NOTES 来说,最诱人的修复方式是让新模型把旧 notes 重写一遍,改成自己更熟悉的风格。这样做成本低,也不需要保留完整历史。但论文的诊断告诉我们,主要问题不是风格。
在 NOTES 的 end-to-end loss 里,总损失是 0.584 ± 0.013,其中 store construction 贡献 0.467 ± 0.014,占 80%;retrieval within notes 只有 0.036 ± 0.009,占 6%;reader residual 是 0.081 ± 0.004。最坏方向,也就是 Llama 写 notes、Qwen 读,construction share 到了 88.8%。
换句话说,事实在写入 notes 时就已经丢了。后面再怎么重写摘要,也不能从摘要里长出原始证据。
论文还直接测试了 style rewriting。Qwen 重写 Llama notes 后,accuracy 变化是 -0.012 ± 0.008;Llama 重写 Qwen notes 后是 -0.042 ± 0.017,而且 Llama 这次干预只完成了目标 notes 的 42%,还在 46% 的 rewrites 里丢掉 exact identifiers。这些结果更像是把问题坐实:迁移失败不是“新 reader 不习惯旧 writer 的文风”,而是关键内容已经不在 store 里。
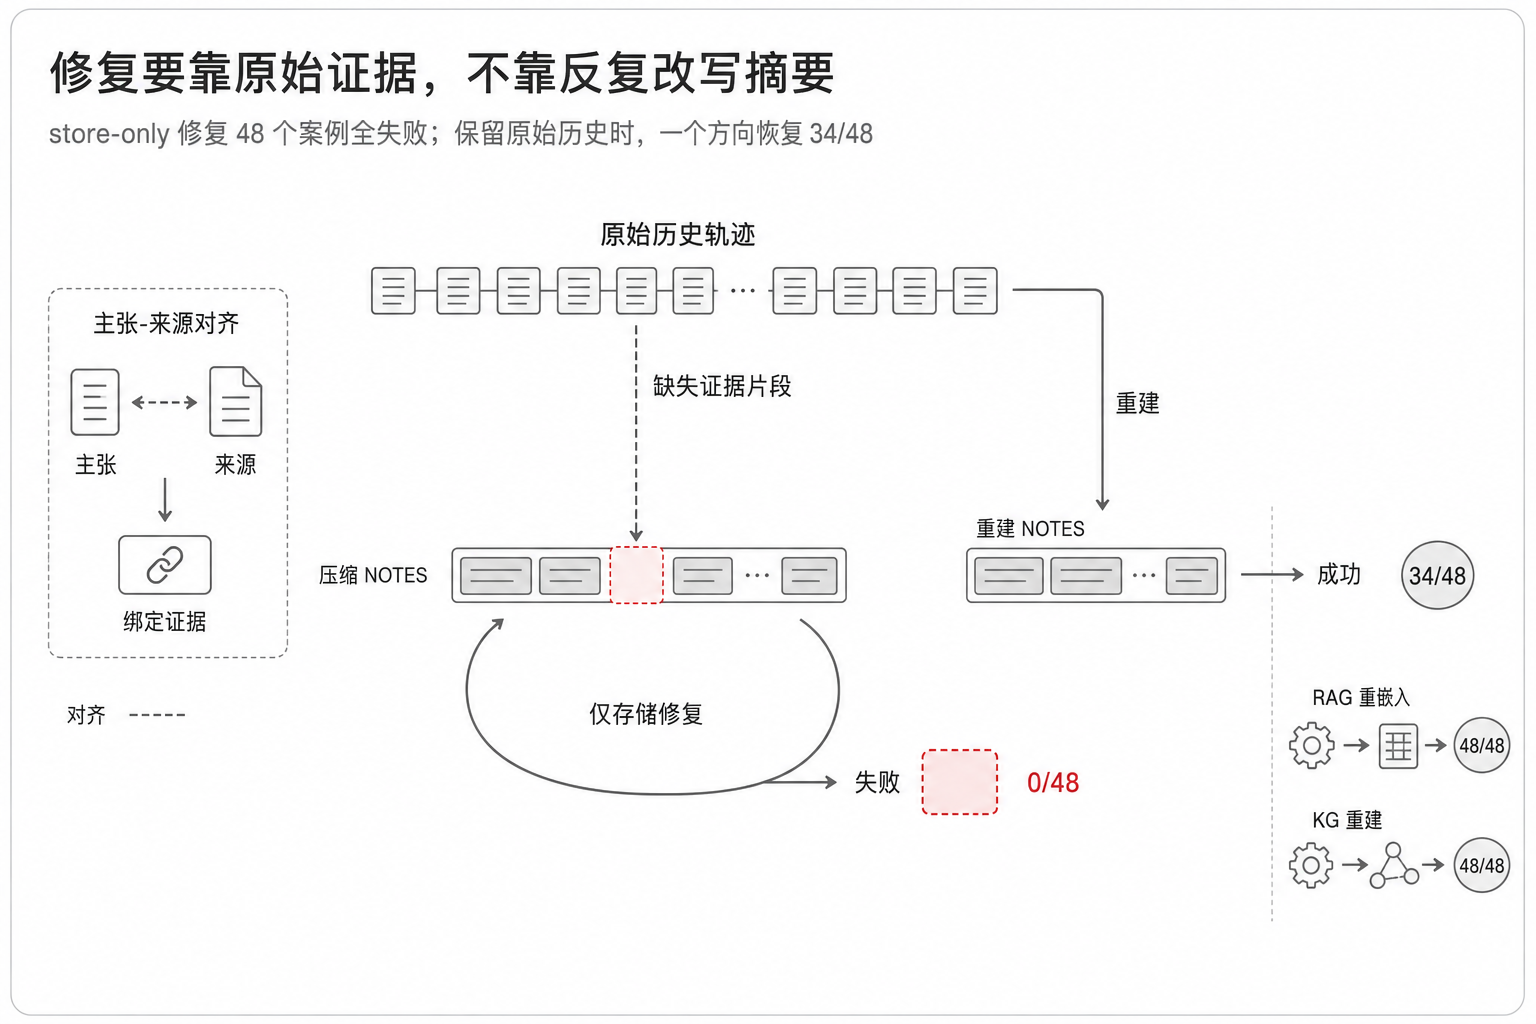
修复实验用 CTR 看三档目标:恢复到新模型 own-store performance 的 90%、95%、99%。store-only NOTES repair 在两个方向、三个目标上都是 0/48。没有原始历史,只看坏掉的 notes,修不回来。
保留 raw history 则给了一个方向的第二次机会。当旧 writer 是 Llama、新 reader 和 repairer 是 Qwen 时,raw-retained NOTES repair 在 90% 目标上恢复 34/48,在 95% 上恢复 28/48,在 99% 上恢复 22/48,中位成本大约 0.75 到 0.76 美元。但反过来,Qwen 到 Llama 的方向,raw-retained repair 是 0/48,因为 Llama 的尝试都在完成前撞到 output-token limit。
这点非常重要。论文没有说“只要保存原始历史就能修”。它说的是:没有原始历史,压缩笔记几乎无从修;有原始历史,也要看 repair model 和资源限制能不能真的完成重建。
结构化修复则便宜得多。RAG re-embed 在两个方向上对 90%、95%、99% 都是 48/48,中位成本约 0.013 美元。KG-fixed schema rebuild 也几乎全成功,成本约为零。这再次说明,越机械、越可重建的结构,迁移和修复越容易审计。
这篇论文证明了什么,也没有证明什么
这篇论文最有价值的地方,不是给出一个“最佳记忆系统排行榜”。它给的是一套迁移思维。
它证明了几件事。
第一,在这 48 个受控历史、两个 8B/7B 级模型、exact-match 随机代码任务里,自由文本 NOTES 对 writer 有明显方向依赖。Qwen 写给 Llama 读会变好,Llama 写给 Qwen 读会显著变差,所以迁移方向必须单独测试。
第二,固定 schema 在这个任务里非常稳定。KG-fixed 的 writer swap 变化只有 +0.0004 ± 0.0020。但这依赖 schema 与任务字段匹配,也依赖它的读取方式;不能外推成“知识图谱普遍优于笔记”。
第三,新旧 embedding 空间混用会静默损失收益。bge-large-en v1.0 到 v1.5 的 full re-embed 带来 +11.90 pp,而 50/50 mixed index 只有 +4.96 pp。维度相同不会保护你。
第四,修复需要源证据。store-only NOTES repair 在所有 48 个案例上都没达到 90% 目标;保留 raw history 时,Qwen 方向能恢复 34/48,但 Llama 方向仍然失败。这说明 recoverability 是证据保留、模型能力和资源限制共同决定的。
它没有证明的也要说清楚。
它没有覆盖所有模型升级,只测试 Llama-3.1-8B-Instruct 与 Qwen2.5-7B-Instruct-1M 这一组跨家族迁移。它没有测试主观、开放式、真实长期聊天里的记忆,因为这里用的是合成历史和 exact answer codes。它的 RAG 设置是单阶段 dense retriever,没有 reranker 或 hybrid search,所以 40% 左右的检索 miss 不是 RAG 的普遍下限。它的 analysis lock 也不是完整公开 preregistration,bootstrap 是看过 t-test 后补跑的 follow-up,虽然决策一致。
但这些边界不削弱它的工程启发。恰恰因为论文把范围说得窄,我们才能更放心地拿走它的原则。
真正的结论:把记忆当成长期基础设施
如果一个 agent 的记忆只活在当前模型的表达习惯里,那它就不是长期记忆,而是一份随模型版本漂移的临时摘要。
这篇论文建议我们把 model upgrade 当成 memory migration。升级前,不要只跑新模型在新任务上的 benchmark;还要让新模型读旧 store,和它自己重建的 store 对比。不要只看平均迁移效果;要看具体 writer → reader 方向。不要把新旧 embedding 混进一个空间;要完整重嵌入或隔离索引。不要以为压缩后的 notes 足够;如果政策允许,保留加密、受限、可删除的 source history,至少为未来修复留一条路。
更抽象地说,agent memory 需要 provenance。每条记忆最好知道它由哪个模型、哪个 prompt、哪个 schema、哪个 embedding 版本、哪个 chunking 策略生成。否则迁移后出错,我们只能盯着最终答案猜原因;有了 provenance,我们才能判断是写坏了、检索坏了,还是 reader 没用好证据。
模型会继续升级。供应商会变,context window 会变,embedding 模型会变,成本曲线也会变。真正能长期服务用户的 agent,不能把记忆设计成某个模型版本的附属品。它应该是一套可读、可查、可重建、可迁移的证据系统。
论文标题问:你的 agent 的记忆能在模型升级后存活吗?
更工程化的问法也许是:当下一个模型接手时,你留下的是一份可验证的历史,还是一段已经丢失证据、但看起来很像记忆的摘要?